pdf-inspector 一天涨 2,524 stars,凭什么?答案是不给每页 PDF 都做 OCR
摘要
pdf-inspector 登上 GitHub Trending,今日获得 2,524 stars。它不做新的 OCR 模型,而是先判断 PDF 哪些页面真的需要 OCR,再把其余页面留给本地 Rust 解析器。
AI 时代,热门 GitHub 项目的 stars 增速快到让我无法想象。8 月 4 日晚,我在 GitHub Trending 看到一个很夸张的增长信号:Firecrawl 的 pdf-inspector 显示 2,524 stars today。爱尔兰时间 22:06,我再查 GitHub 仓库元数据,累计 stars 已经是 9,847。两个页面的累计数有缓存差异,但 GitHub Trending 给出的当日增长信号没有歧义。
我小小研究了一下这个项目,现在给大家分享它为什么不是又一个 OCR 模型,以及这轮关注背后有哪些近期变化。期望对大家有所帮助。
数据口径:2,524 直接引用 GitHub Trending Today 在 2026 年 8 月 4 日 22:06(Europe/Dublin)的页面,不是用两个累计 stars 相减推算;9,847 取自同一时间的 GitHub 仓库元数据。
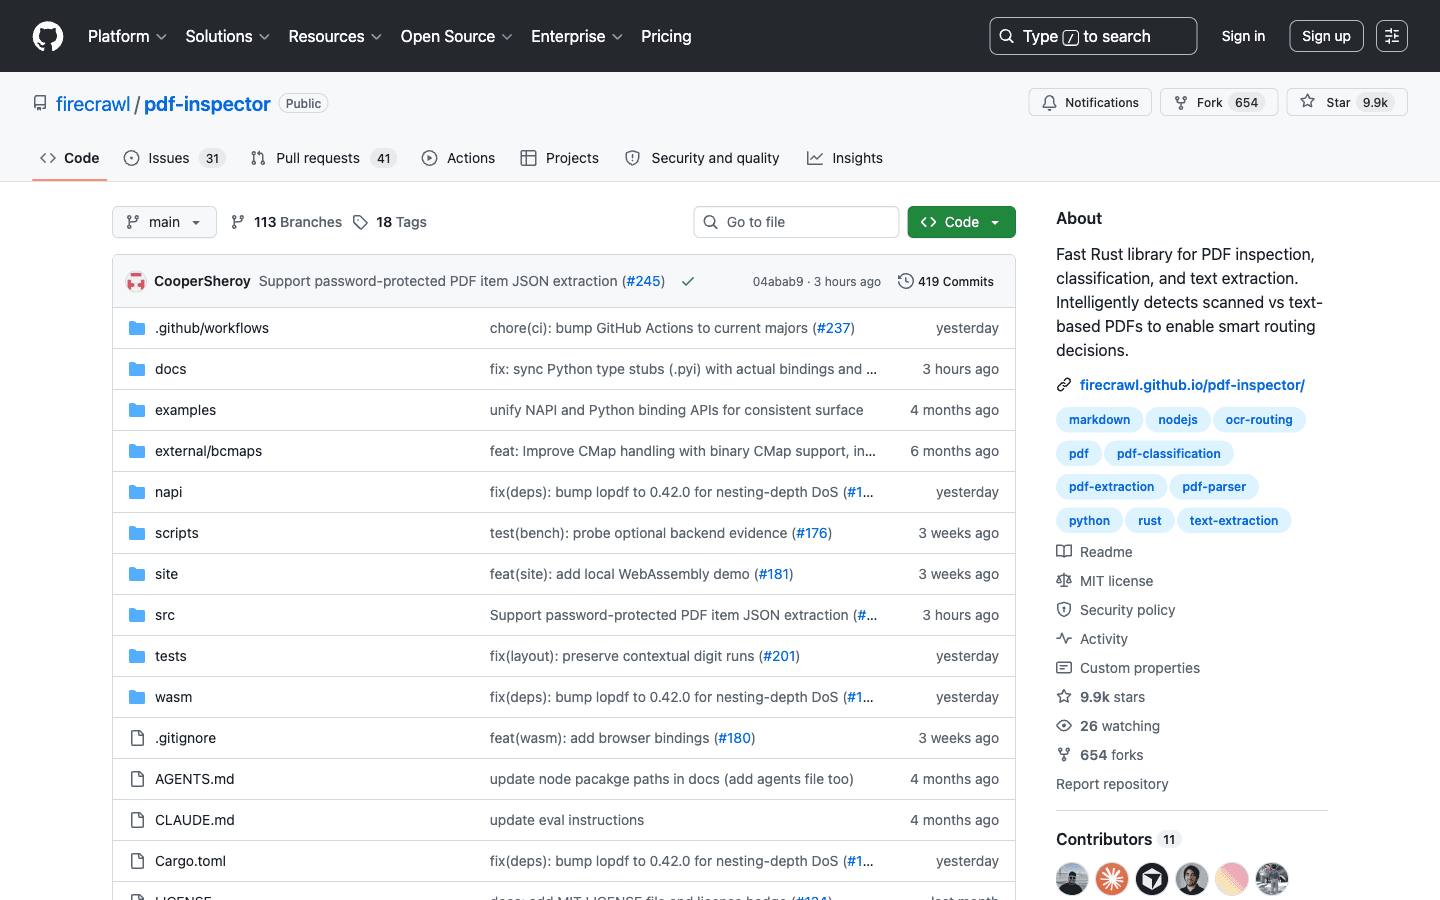
pdf-inspector 仓库首页:一个纯 Rust 的 PDF 分类与文本提取库,主打「先判断扫描页还是文本页,再做智能路由」。
它不是另一个 OCR 模型
PDF 进入 AI Agent 或 RAG 管线之后,常见做法是统一渲染成图片,再交给 OCR 或视觉模型。这样确实省判断,但原本就带可提取文字的页面也走了一遍 GPU,延迟和费用一起增加。
pdf-inspector 的选择不同。它是一套纯 Rust 的本地解析器,没有 ML 模型,也不调用外部服务。它先把文档或页面分成 TextBased、Scanned、ImageBased 和 Mixed,再决定后续路线:仓库 README 给出的典型流程大致如下。
PDF
  ↓
pdf-inspector 分类
  ├─ 可提取文字 → 本地解析 → Markdown
  └─ 扫描页 / 编码异常 → OCR 或视觉模型
Firecrawl 在自家管线里观察到,大约 54% 的 PDF 不需要 OCR,因此先分类可以让这部分文档跳过昂贵路径。这个比例来自 Firecrawl 自己的工作负载,不能直接当成所有公司的通用分布;但“先确认是否需要 OCR”这件事,本身很容易迁移到别的文档管线。
分类器看的是 PDF 内部
它并不是把每页渲染出来,再用另一个模型判断有没有文字。
在 detector.rs 里,分类器直接检查 PDF content stream:Tj 和 TJ 表示显示文字,图像对象、字体编码和图像覆盖率则帮助它识别扫描页、混合页,以及“看起来有文字操作符,但实际无法可靠解码”的页面。结果里不只有文档类型,还有置信度和 pages_needing_ocr,因此一个 200 页文件里只有 7 页需要 OCR 时,不必把另外 193 页一起送过去。
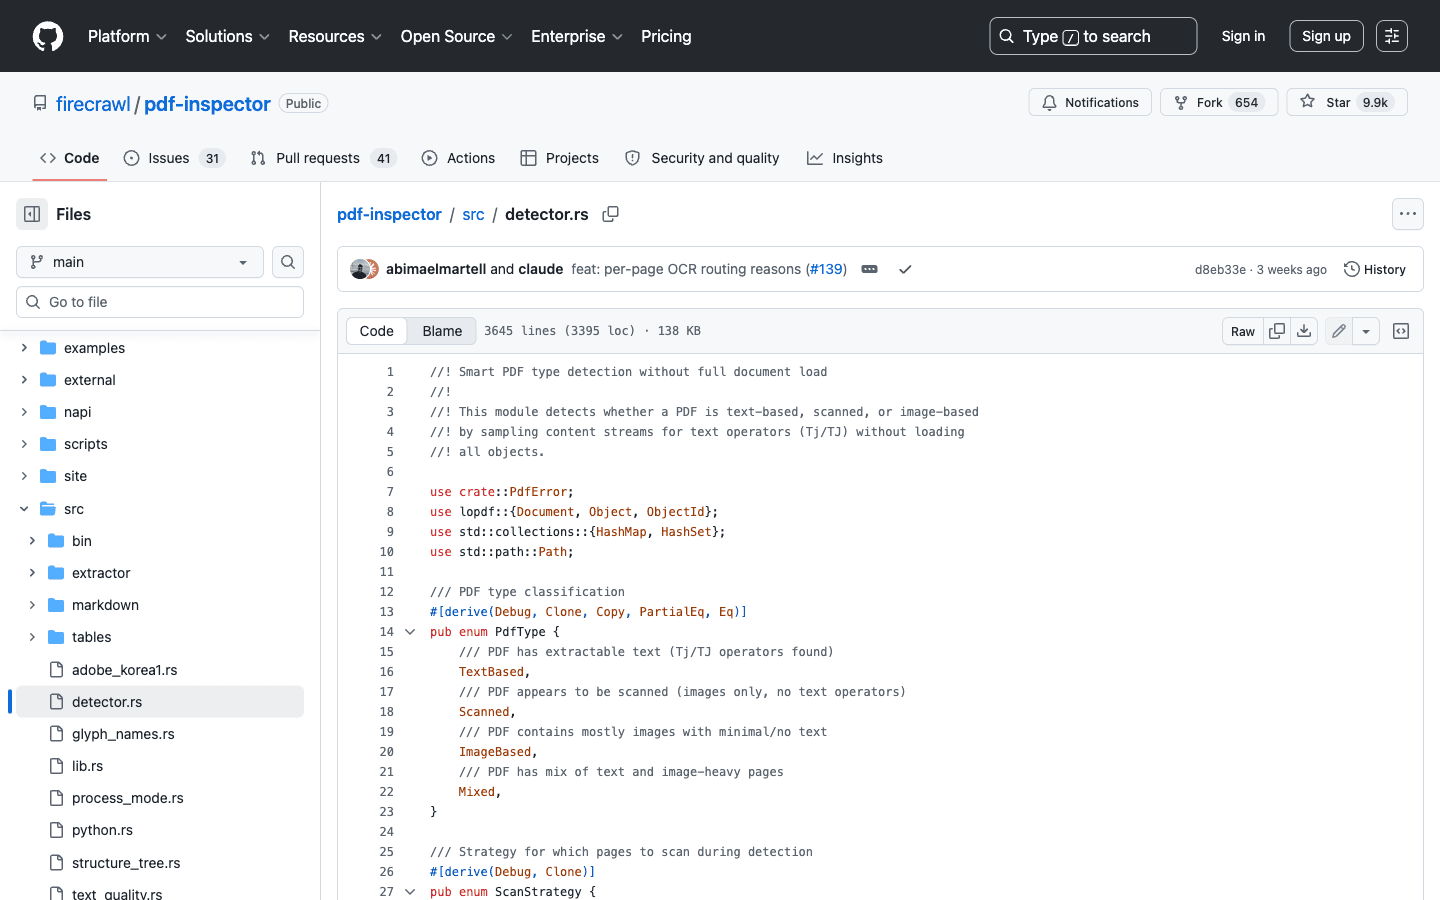
源码印证:模块注释直接写着「sampling content streams for text operators (Tj/TJ) without loading all objects」,PdfType 枚举就是 TextBased / Scanned / ImageBased / Mixed 四类。
它还提供四种扫描策略:默认的 EarlyExit 适合快速路由;Full 会读完每一页,分清 Mixed 和 Scanned;Sample(n) 适合超大 PDF;Pages 则允许调用方只检查已知页码。
分类之后,lib.rs 会让检测和提取共享同一个 document handle,避免重复加载。Markdown 阶段再利用字号、字体名称、坐标、矩形和线段,恢复标题、列表、代码块、多栏阅读顺序和表格。它的核心差异不在“识别更多内容”,而在“先把不同内容送到合适的处理路径”。
快来自少走一段路
仓库在 7 月 31 日刷新了一组可复现实验:200 份 PDF,关闭 OCR,只比较本地直接提取引擎。下面是 README 公布的完整批次结果,分数越高越好,时间越低越好。
| 引擎 | Overall | Reading Order | Tables | Headings | 200 份耗时 |
|---|---|---|---|---|---|
| pdf-inspector | 0.875 | 0.915 | 0.814 | 0.788 | 0.470s |
| LiteParse | 0.873 | 0.913 | 0.693 | 0.811 | 0.750s |
| OpenDataLoader | 0.831 | 0.902 | 0.489 | 0.739 | 2.569s |
| PyMuPDF4LLM | 0.735 | 0.886 | 0.401 | 0.424 | 17.117s |
| MarkItDown | 0.589 | 0.844 | 0.273 | 0.000 | 16.165s |
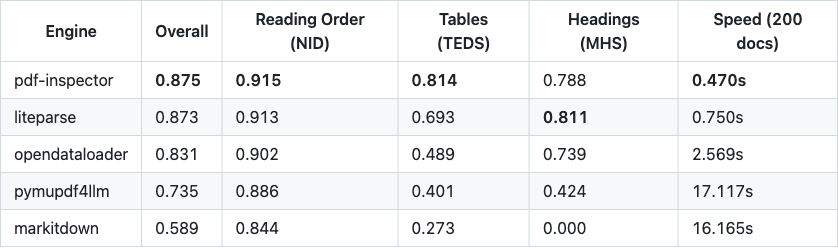
同一组数据的 README 原始截图,方便核对:pdf-inspector 在总分、表格还原和速度上都排在前列。
这组数据适合说明本地文本提取的速度与结构恢复,不适合拿来证明它全面胜过带 OCR 或视觉模型的解析器。实验只用了一个 200 份文档的 corpus,运行环境是 Apple M4 Pro;项目也公开了配置、逐文档预测和评测输出,方便换成自己的文件复测。
为什么偏偏是现在
pdf-inspector 并不是今天才发布。GitHub 元数据显示仓库创建于 2 月 6 日,Firecrawl 在 4 月 14 日发布 Fire-PDF 时已经介绍过它:文本页由本地解析器处理,扫描页才进入神经网络布局模型和 OCR。官方当时给出的结果是新管线比旧解析器快 3.5 到 5.7 倍,平均每页低于 400ms。这组数字描述的是完整 Fire-PDF 服务,不是开源库单独运行的成绩。
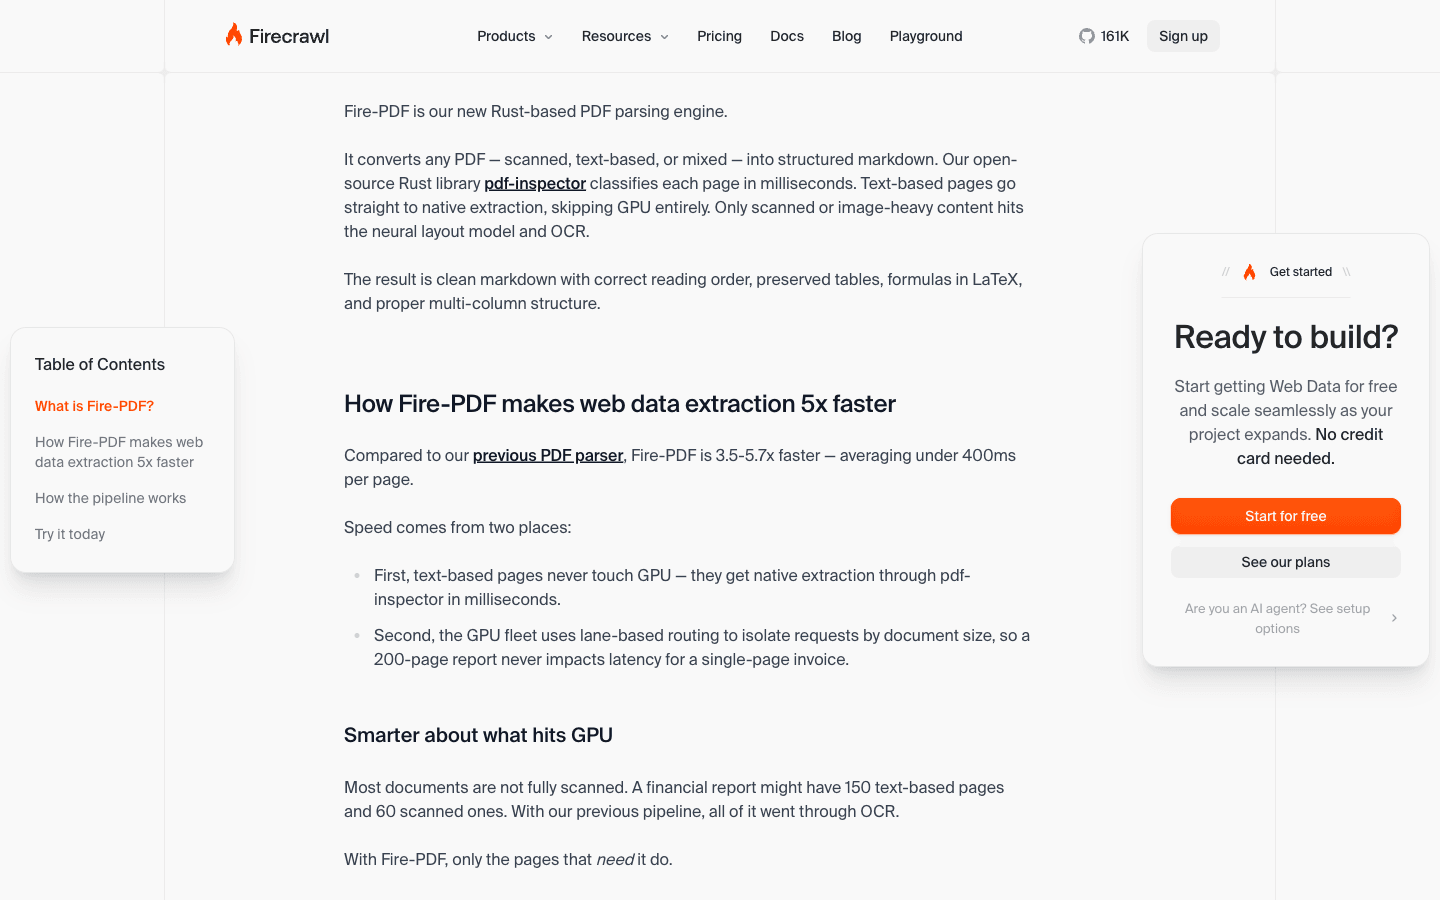
4 月 14 日 Fire-PDF 发布博客:文本页走本地提取、跳过 GPU,只有扫描页和图像页才进神经网络布局模型和 OCR。
最近几周,几个传播条件凑到了一起:Node 包 @firecrawl/pdf-inspector 已经更新到 1.11.1;7 月 31 日的 benchmark 把结果、运行环境和原始输出补齐;8 月 3 日到 4 日又连续合入 Linux musl、ARM64、密码保护 PDF 和类型声明修复。项目还在 8 月 3 日升级 lopdf,修复深层嵌套 PDF 可能触发的 stack overflow DoS。
这些变化能解释它为什么在此刻更容易被安装、比较和转发,却不能证明某一次更新就是唯一推手。真正适合传播的,还是它把一个复杂问题压成了一句话:不是每一页 PDF 都该做 OCR。
先在自己的 PDF 上跑
Node.js 用户可以直接安装现成的 N-API 包:
npm install @firecrawl/pdf-inspector
import { readFileSync } from "node:fs";
import { classifyPdf, processPdf } from "@firecrawl/pdf-inspector";

const pdf = readFileSync("document.pdf");
const classification = classifyPdf(pdf);

if (classification.pdfType === "TextBased") {
  const result = processPdf(pdf);
  console.log(result.markdown);
} else {
  console.log(classification.pagesNeedingOcr);
}
适合先试的人,是正在处理研究论文、财报、发票、法律文件,或者给 AI Agent 做文档摄取的开发者。不要先拿十份排版规整的英文报告下结论,至少补上这些样本:中日韩字体、双栏论文、跨页表格、混合扫描页、损坏编码和密码保护文件。
还要检查两件事。第一,pdf-inspector 负责分类和本地提取,不会凭空补上扫描页的文字,生产管线仍要准备 OCR fallback。第二,PDF parser 面对的是不可信二进制输入;项目的安全策略(SECURITY.md)把越界读取、无限分配和拒绝服务都列在范围内,部署时应固定已修复版本,并在隔离进程里设置内存和执行时间上限。
如果你的 PDF 量已经大到 OCR 费用和等待时间都能被感知,先统计自己有多少页面原本就带可提取文字。这个数字,才决定 pdf-inspector 能帮你省下多少处理步骤。
参考链接
- pdf-inspector 仓库:https://github.com/firecrawl/pdf-inspector
- GitHub Trending Today:https://github.com/trending?since=daily
- detector.rs:https://github.com/firecrawl/pdf-inspector/blob/main/src/detector.rs
- lib.rs:https://github.com/firecrawl/pdf-inspector/blob/main/src/lib.rs
- 安全策略 SECURITY.md:https://github.com/firecrawl/pdf-inspector/blob/main/SECURITY.md
- benchmark 配置与评测输出:https://github.com/firecrawl/opendataloader-bench/tree/abi/pdf-parser-benchmark-results
- Fire-PDF 发布博客:https://www.firecrawl.dev/blog/fire-pdf-launch
相关文章
2026年10月1日
OpenRig 冲上 Trending:把 Claude Code 和 Codex 编成一支队伍
OpenRig 在 GitHub Trending Today 获得 622 个 stars 的窗口信号。它用可恢复的队列、席位与权限记录,把 Claude Code 和 Codex 放进同一套多 Agent 工程流程。
2026年9月30日
NVIDIA OpenShell,把 Agent 的权限写进策略
OpenShell 在 GitHub Trending Today 获得 978 个 stars 的窗口信号。它把文件、网络和凭证边界做成可执行策略,适合开始让 Agent 接触真实开发环境的团队。
2026年9月29日
19.5k stars 的 notebooklm-py,正在把 Gemini Notebook 接进 Agent
GitHub Trending Developers 第一名背后,notebooklm-py 把 Gemini Notebook 的资料库、生成能力和导出流程包装成 CLI、MCP 与 Agent Skill;但它是依赖未公开接口的非官方项目。
最近一封 · Sample
OpenRig 冲上 Trending:把 Claude Code 和 Codex 编成一支队伍
“OpenRig 在 GitHub Trending Today 获得 622 个 stars 的窗口信号。它用可恢复的队列、席位与权限记录,把 Claude Code 和 Codex 放进同一套多 Agent 工程流程。”
—— william
来信
里面装的是
- 新文章 — 写完一篇就寄一封,不攒货
- 这周读到的、看到的、好用的工具
- 正在折腾的实验,附带翻车记录
约莫 1–2 周一封 · 随时退订
合作伙伴
CompeteMap — 英国及爱尔兰学生竞赛一站式搜索
数学、编程、科学、写作等各类竞赛信息汇总,支持按年龄和科目筛选,再也不错过报名截止日。