Jev 实测:这款爆火的极速决策模型的基本玩法
摘要
TypeSafe AI 的 Jev 发布当天在 Hacker News 拿到 1679 分。我搭了一个 Playground 跑了五个场景,把官方宣称、独立实测和自己测出来的数字分开放,说说它适合什么、不适合什么。
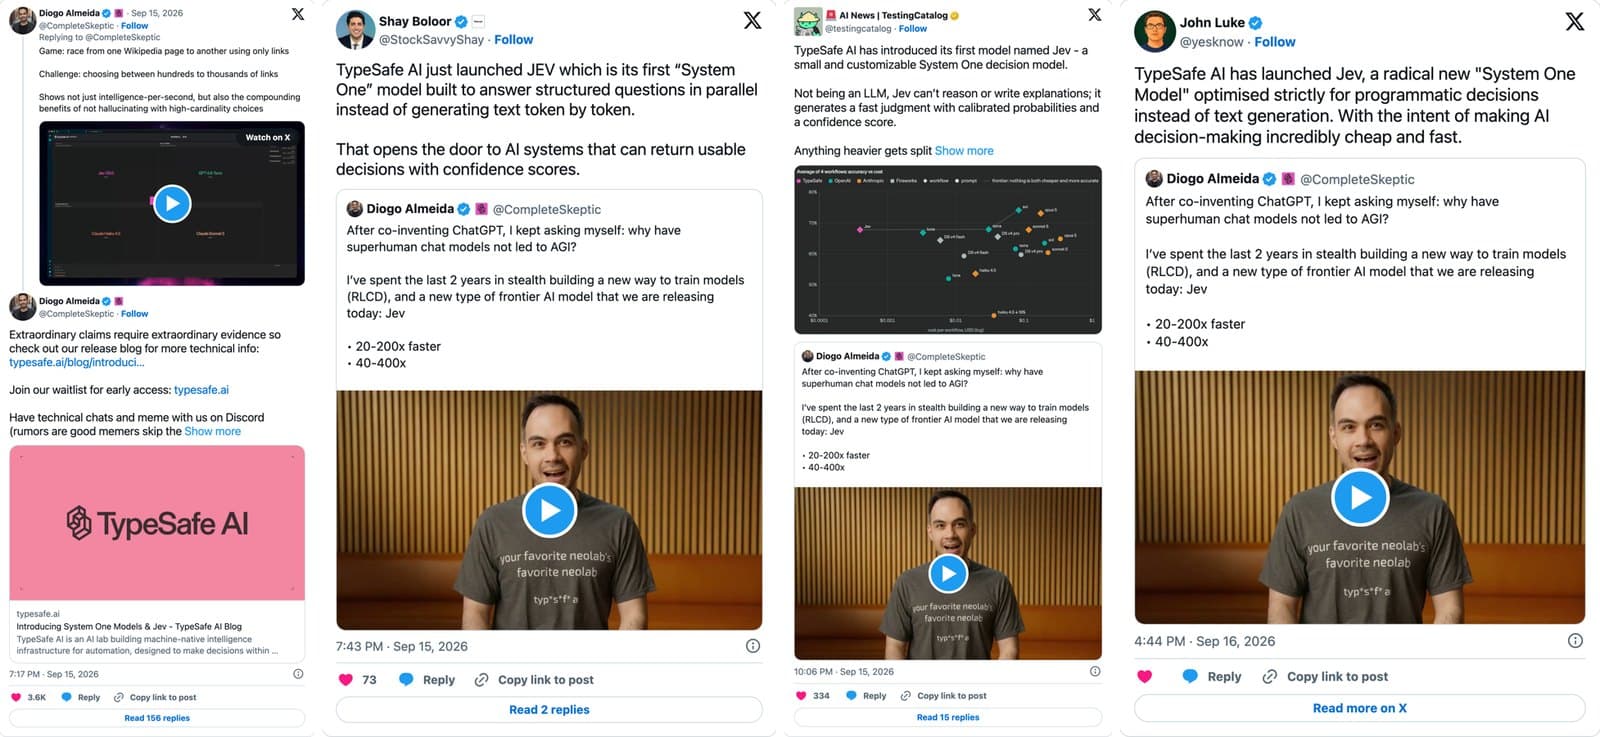
9 月 15 日,TypeSafe AI 结束隐身,发布了它的第一个模型 Jev。当天在 Hacker News 拿到 1679 分、四百多条评论,第二天 Vercel 宣布 AI Gateway 接入。创始人 Diogo Almeida 之前在 OpenAI,是 RLHF 的共同发明人,这次做的东西正好相反:一个不聊天的模型。
我这两天把它体验了一番,基本了解了它是做什么的,擅长做什么,不适合做什么。这篇是视频的文字版,我会先说它是什么,再看官方数字和独立实测差多少,然后用自己搭的 Playground 把五个典型场景跑一遍,最后看看官方给 coding agent 准备的 skill。所有 Playground 里的数字都是我自己通过 Vercel AI Gateway 跑出来的。期望对大家有所帮助。
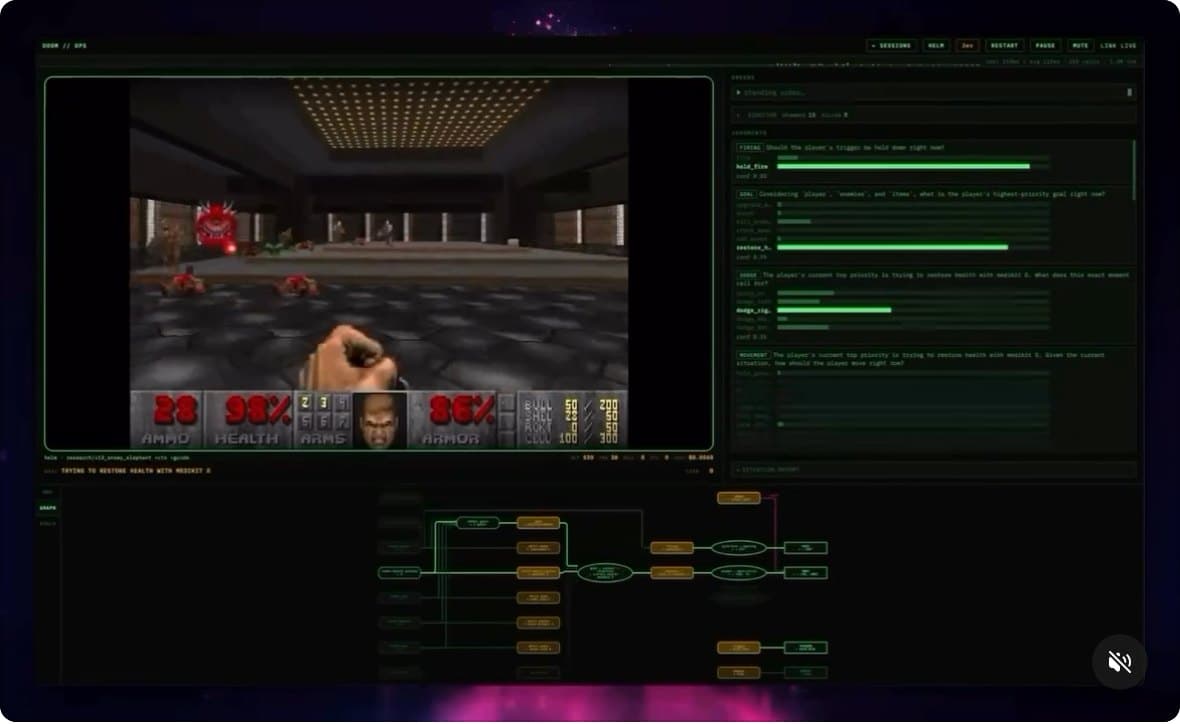
官方放出的演示里最直观的是这个:DOOM 里正在操作的不是人,是 Jev。它每秒做大约十次决策,往前、往左、开火还是躲。它不看画面,只看游戏状态;也不会说一个字,只在几个选项里选一个,并告诉你它有多确定。
它是什么
TypeSafe 给它起了一个新类别的名字,System One Model,直译是“快系统模型”,社区更多叫它决策模型,我叫它极速决策模型。这个词来自《思考,快与慢》:系统一快、凭直觉,系统二慢、要推理。现在的语言模型都是系统二,你问一个问题,它一个 token 一个 token 往外生成。
但软件里有大量决策根本不需要一段话:这条工单该转给谁,这条评论是不是垃圾,这个请求该交给便宜模型还是贵模型。答案是一个选项、一个分数、一个是或否。让语言模型先写解释、再输出 JSON、再由代码解析,既慢又贵,还可能格式出错。
Jev 的做法:把一段状态和一组带类型的问题一起给它,它对所有问题并行评估,一次返回全部答案,每个答案都带一个校准过的概率。官方的说法是“状态进去,类型化的概率出来”。
它只回答三种问题:
- Choice - 从你给的选项里选一个,返回选中项和每个选项的概率
- Score - 按有序的评分表打分,返回每档的概率和插值出来的分数
- Noul - Bernoulli 的缩写,“这句话为真吗”,返回 0 到 1 的概率;AI SDK 里叫 boolean
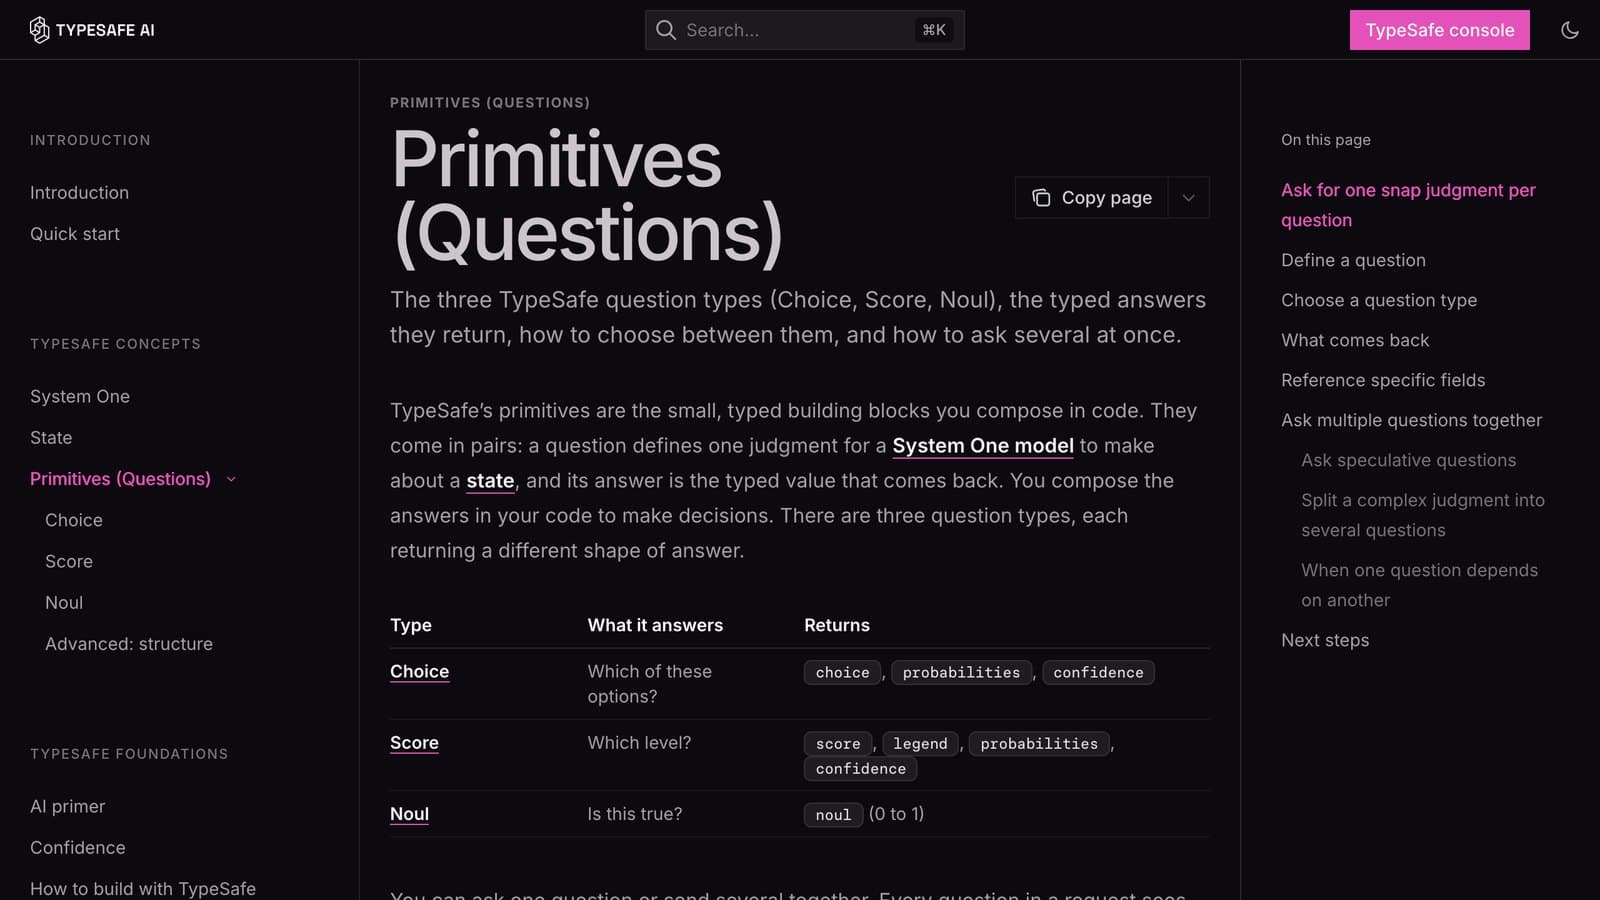
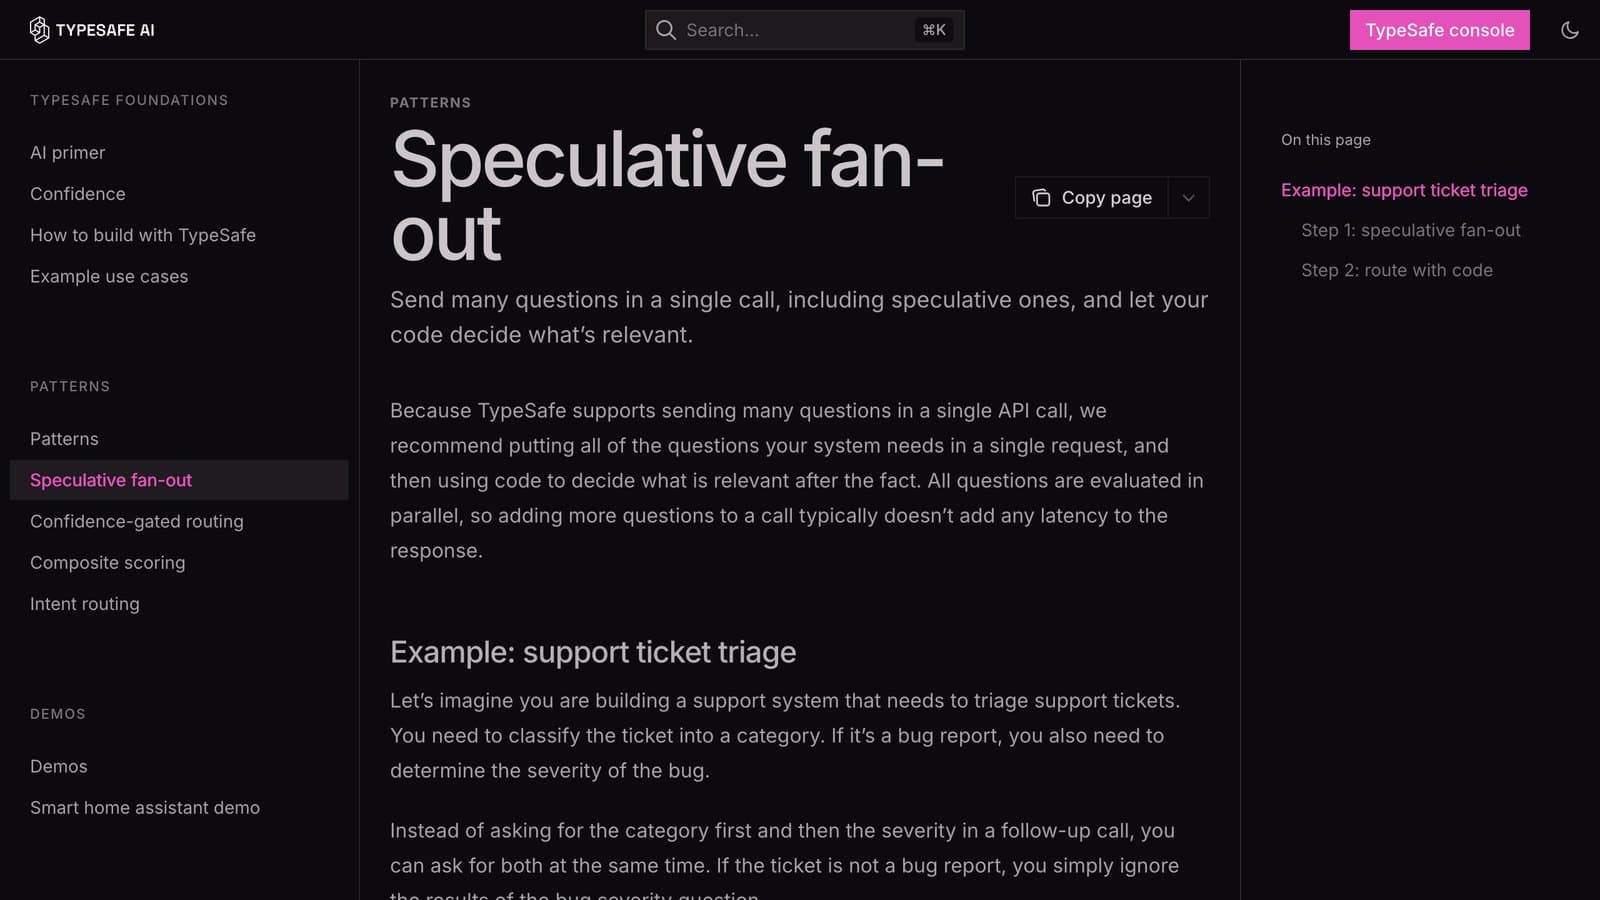
三种问题混在一次请求里,对同一段状态并行评估,互不干扰。官方特别强调:不要让模型在长上下文里连环推理,把复杂决策拆成一组原子问题,一次全问,剩下的逻辑交给代码。文档里给这个做法起了名字,speculative fan-out。
官方数字,以及冷静一下
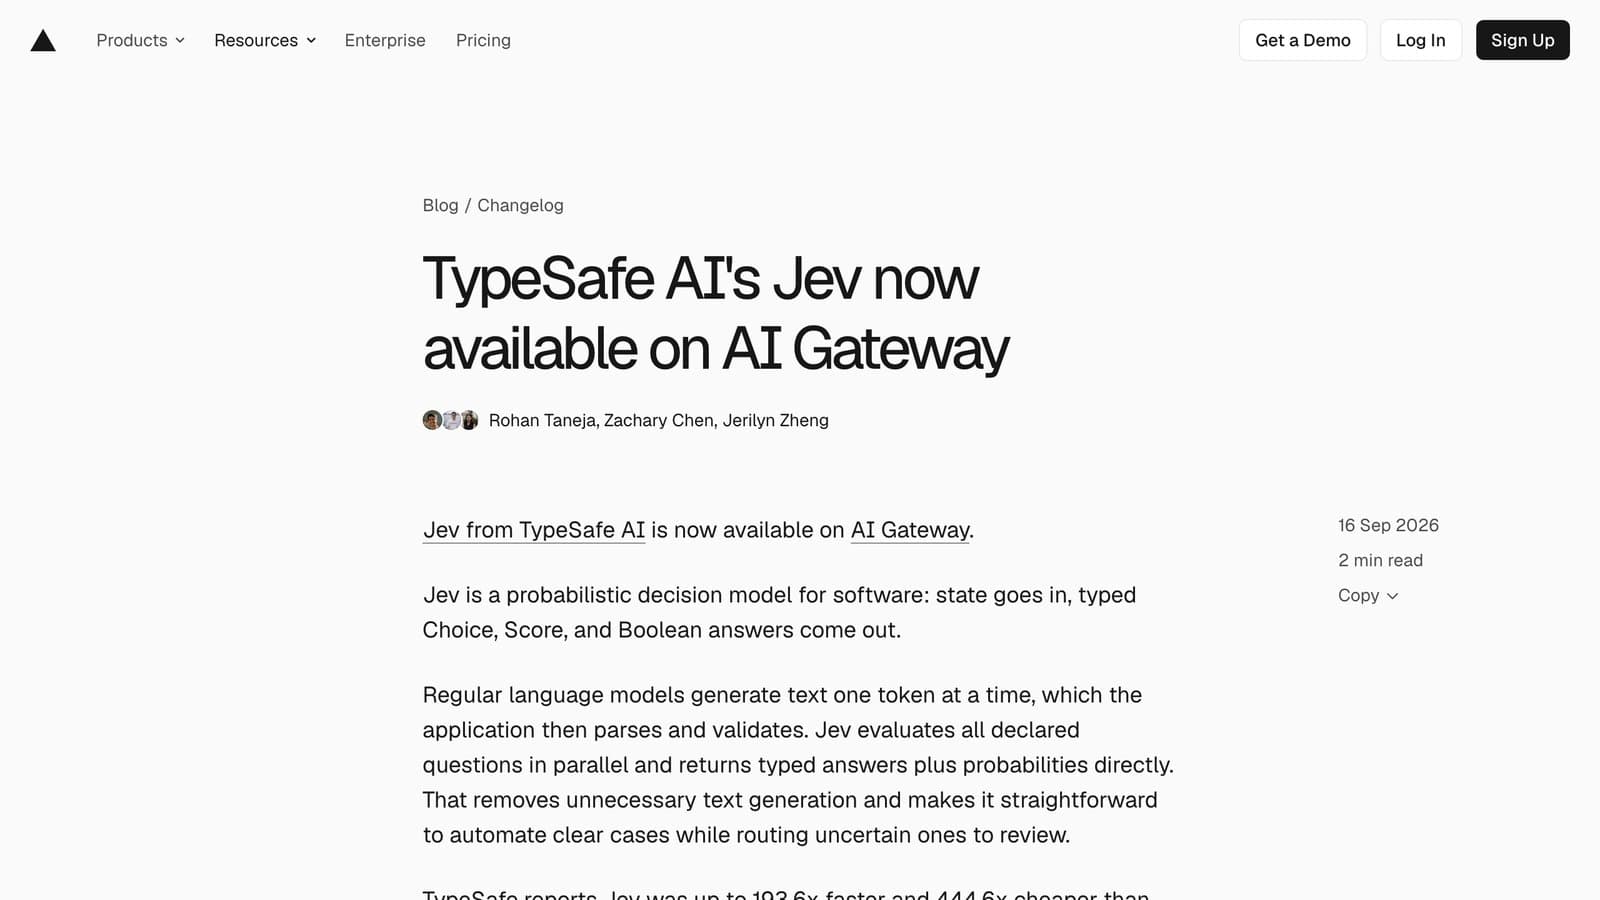
官方博客宣称:输入每百万 token 0.042 美元,输出免费;端到端延迟 70-500 毫秒;在他们自己的工作流评测上准确率 67.8%,和 GPT-5.6 Terra 的 67.9% 持平,成本是后者的 1/76,速度快 25 倍;结构化输出错误率 0%。
发布两天后有人做了独立审计(SamuelSacco/jev-exploration),结论分四类:
- 属实:HTTP 契约、并行批处理、不确定时给出接近 0.5 的概率
- 属实但夸大:官方说 20-400 倍,独立测得 5-25 倍;延迟从海外测是 1.6-3.7 秒;准确率与中档模型持平,落后于推理模型
- 不成立:“不会幻觉”。官方文档自己写了一句,类型化输出保证的是接口,不是真相
- 没法验证:校准。它说 80% 的时候是不是真有 80% 是对的,目前没有公开的校准曲线
我自己从 Vercel AI Gateway 走,上游耗时 210-340 毫秒,端到端 350 毫秒到 1 秒,首次请求最慢。延迟这一项在我这里和官方说的区间对得上,网络不同结果会差很多。
我的判断:便宜和快是真的,倍数看你拿什么比;类型安全是真的,但那是格式安全,不是答案正确;概率有没有校准,得拿自己的标注数据去验。
社区一周
awesome-jev 列表收了四十多个项目,分类和路由最多,其次是验证护栏、打分排序、智能体决策、游戏机器人。我挑两个。
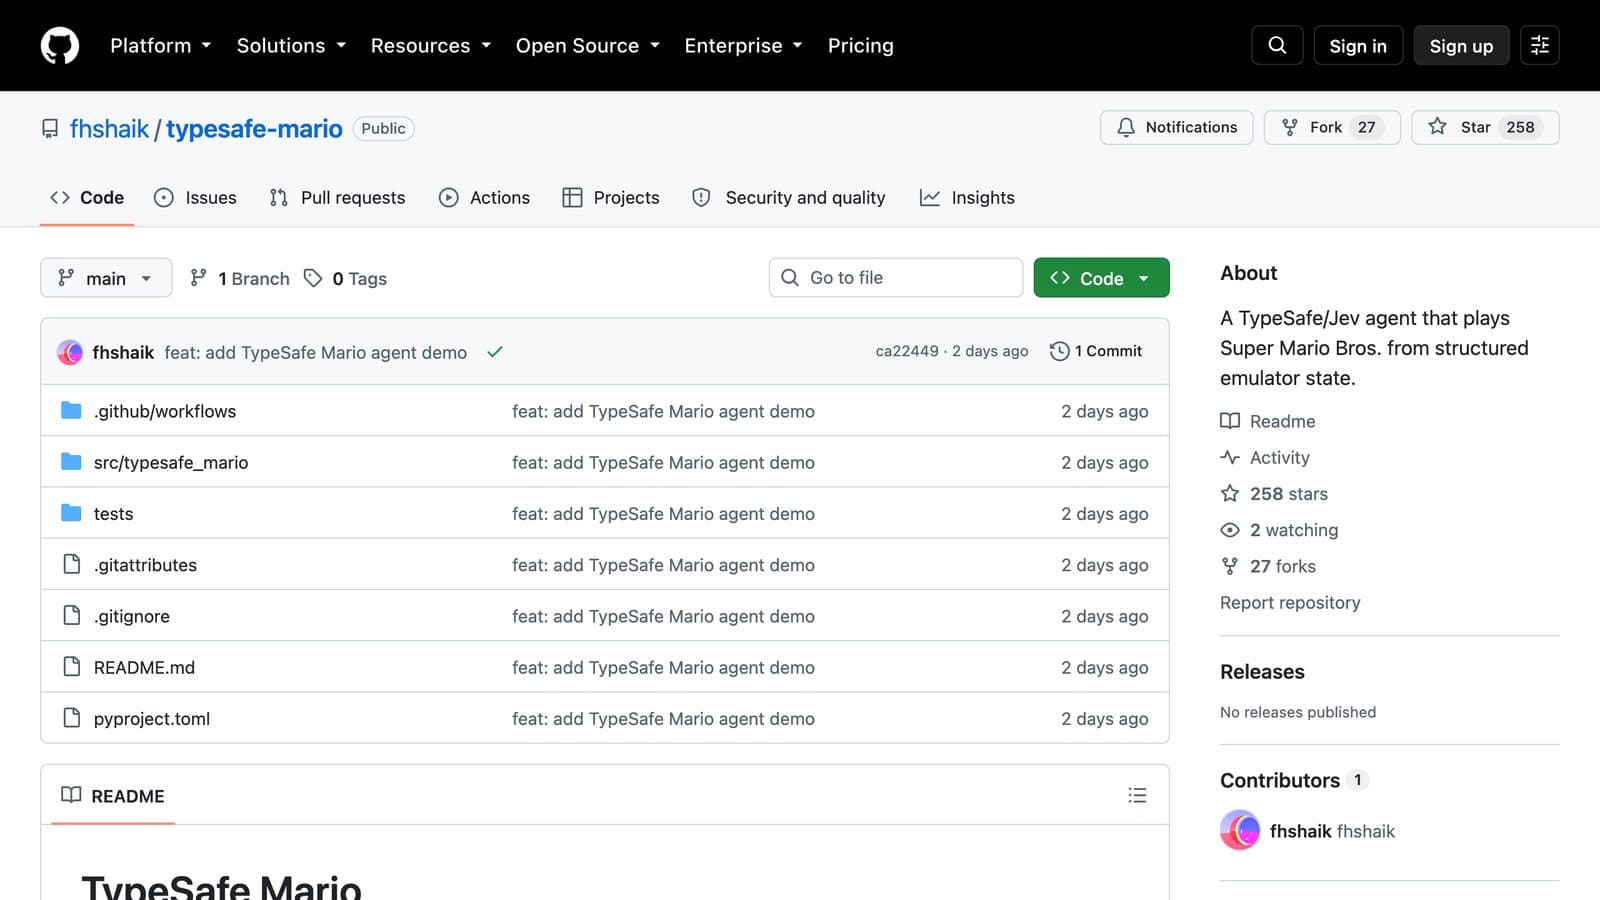
typesafe-mario 让 Jev 玩超级马里奥:把 NES 内存解析成 JSON,一个 Choice 选手柄动作,一个 Noul 判断现在跳有没有用,一个 Score 估计眼前的危险程度,每八帧决策一次。
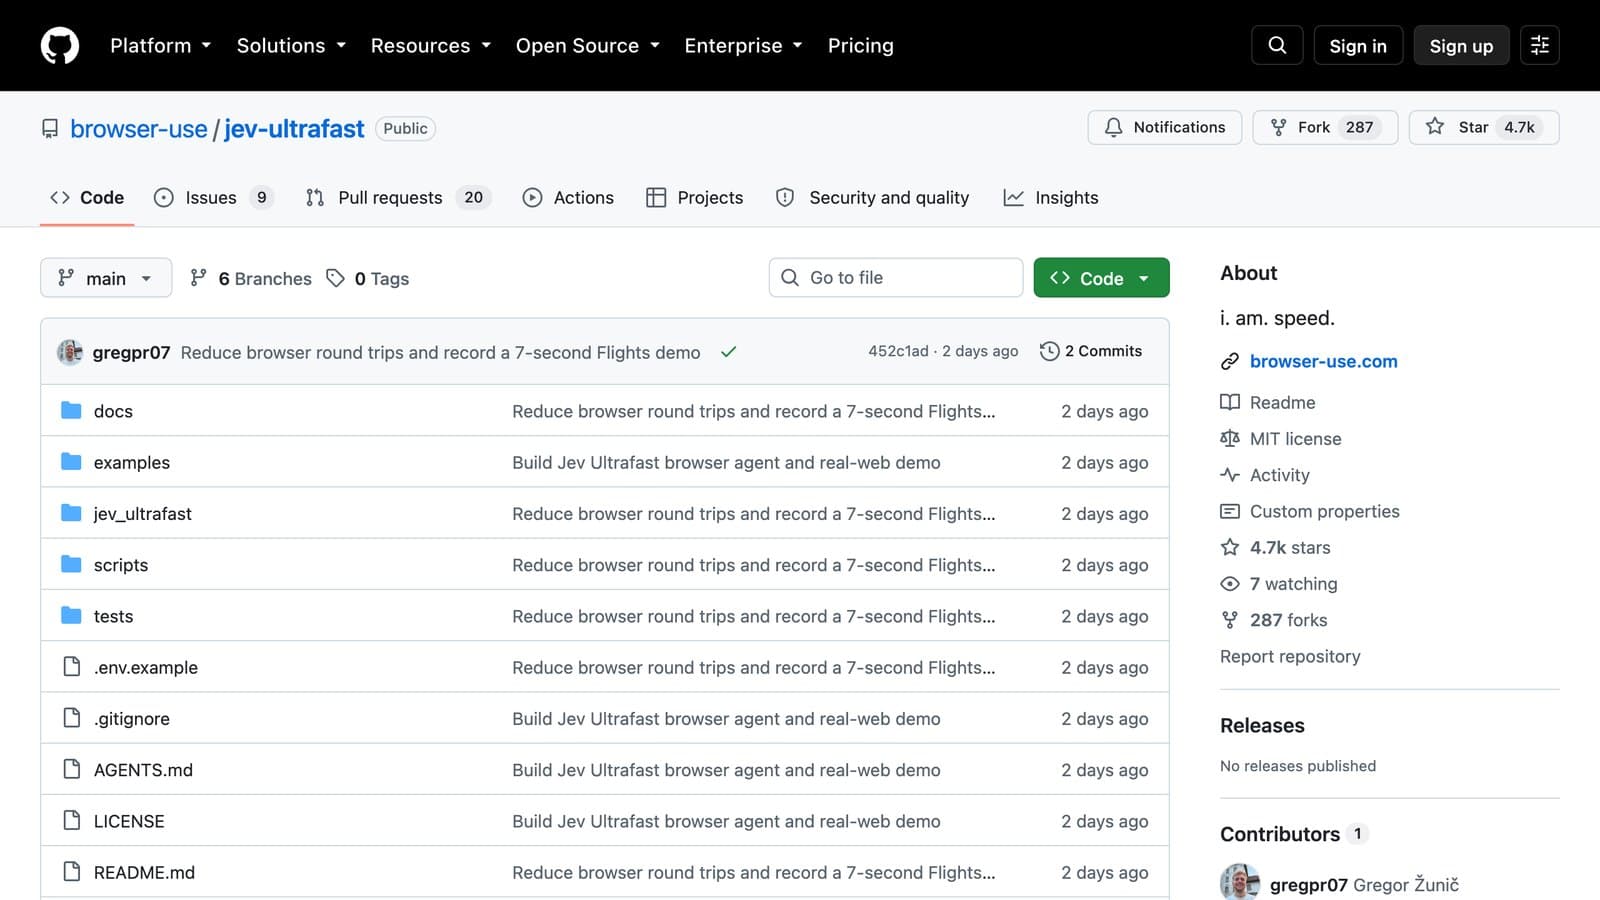
browser-use/jev-ultrafast:浏览器智能体每一步做两个决定,做什么操作、对哪个元素,做成两个 Choice 一次往返,只有要输入文字时才调小语言模型。Google Flights 搜一张机票 7.1 秒,CDP 调用从一千多次降到一百次。
搭一个 Playground
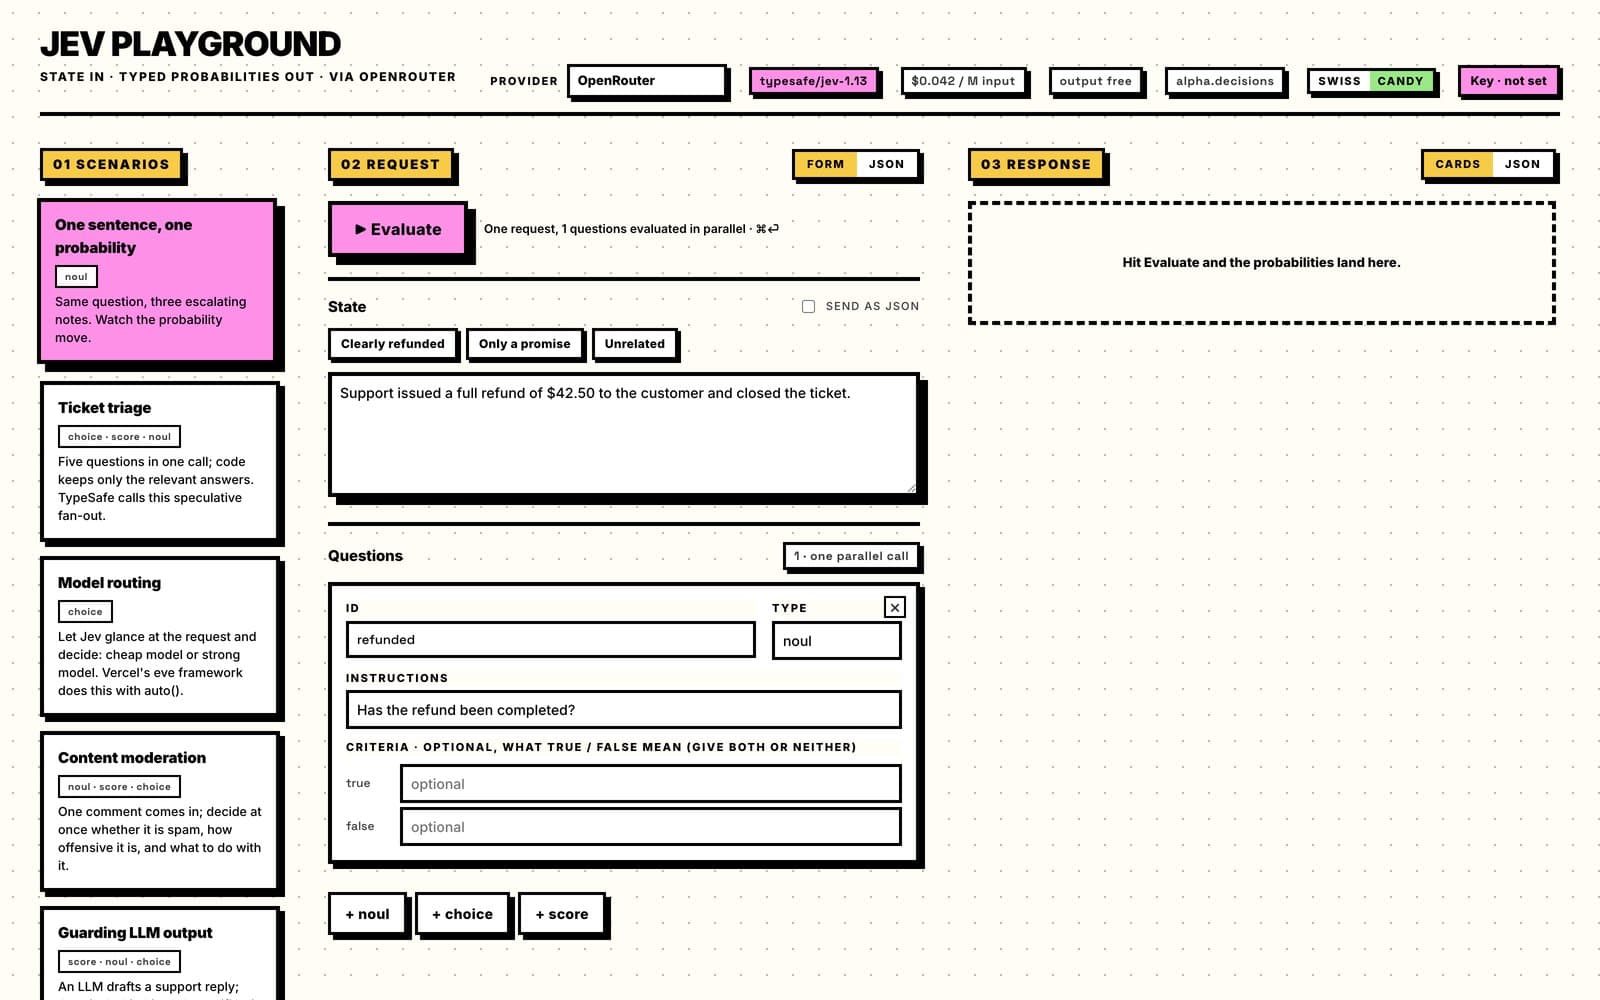
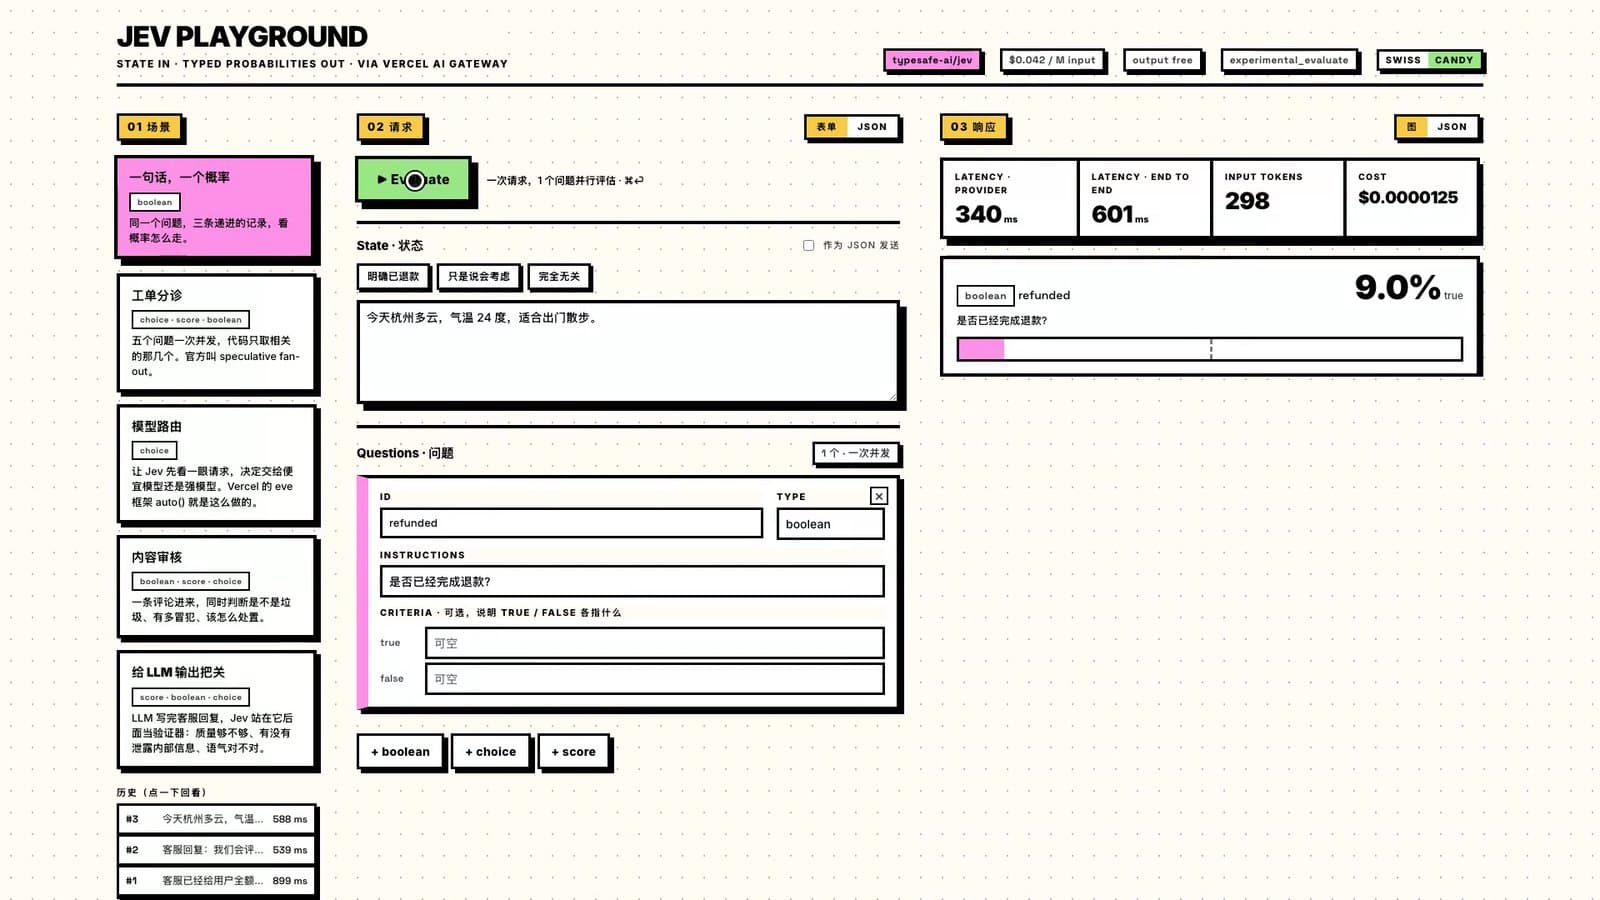
我把 Playground 放在了 tryjev.xyz,代码在 sugarforever/tryjev。它不带服务端的 key,你用自己的 OpenRouter、Vercel AI Gateway 或 TypeSafe 的 key,key 只存在浏览器本地,每次请求转发一下。左边预设场景,中间请求,右边响应,两边都能切到 JSON 看原始内容。
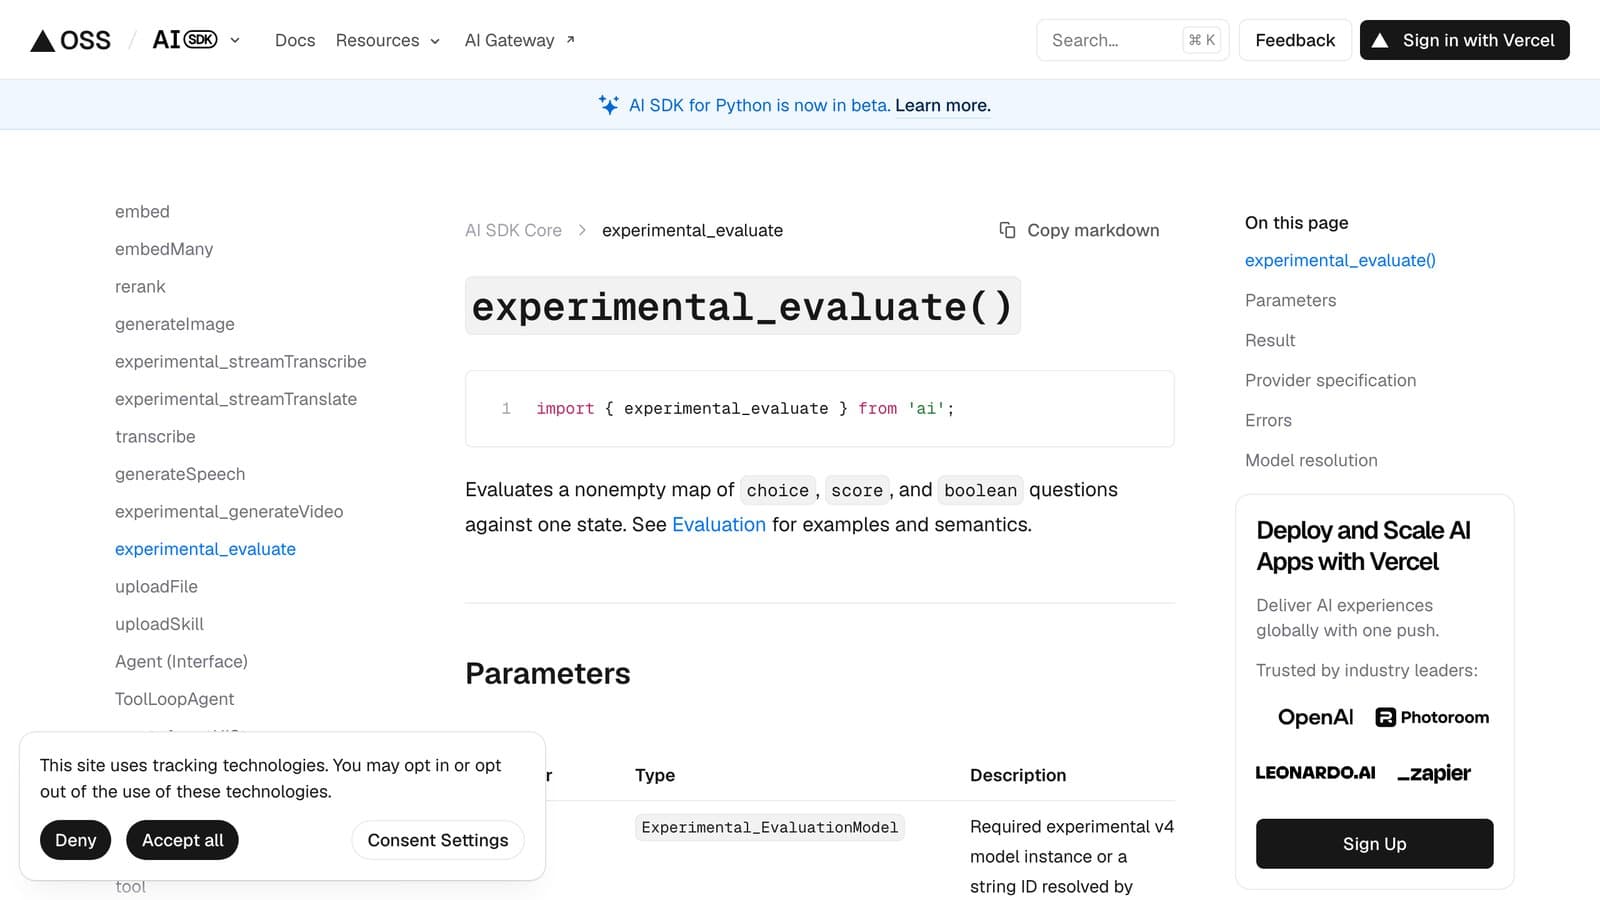
走 AI Gateway 的话,模型 id 是 typesafe-ai/jev,只能通过 AI SDK 7 的 experimental_evaluate 调用,OpenAI 兼容端点不支持。服务端就这么几行:
import { experimental_evaluate as evaluate } from 'ai';
import { createGateway } from '@ai-sdk/gateway';

const gateway = createGateway({ apiKey });
const result = await evaluate({
  model: gateway.evaluationModel('typesafe-ai/jev'),
  state,
  questions,
  maxRetries: 0,
});
// result.answers、result.usage、result.providerMetadata.typesafe.confidence
OpenRouter 走的是它 SDK 里的 alpha.decisions.create,模型 id 是 typesafe/jev-1.13;TypeSafe 自己的 API 是 POST /v1/systemone。三条路的请求和响应形状一致,只有 boolean 和 noul 的叫法不同。
下面五个场景的数字是我通过 AI Gateway 跑出来的。
一句话,一个概率。“客服已经全额退款 42.5 元并关闭工单”,问“是否已完成退款”,返回 0.97;换成“我们会评估您的情况,三个工作日内答复”,0.03;换成“今天杭州多云”,0.09。它不会因为无关就给 0.5,问题问的是“是否已完成”,没证据就是没完成。
工单分诊,五问并发。一条登录不上又要退款的工单,一次问五个问题:类别 Choice、故障严重程度 Score、有没有复现步骤、是否要求退款、用户情绪。五个答案一起回来,上游 245 毫秒,和一个问题时差不多。类别 bug 0.65 / billing 0.35,confidence 0.53。故障严重程度只在类别是故障时才有意义,退款只在类别是收费时才有意义,传统做法要串行问,Jev 的建议是全部一起问,代码只取相关的几个,这就是上面说的 speculative fan-out。
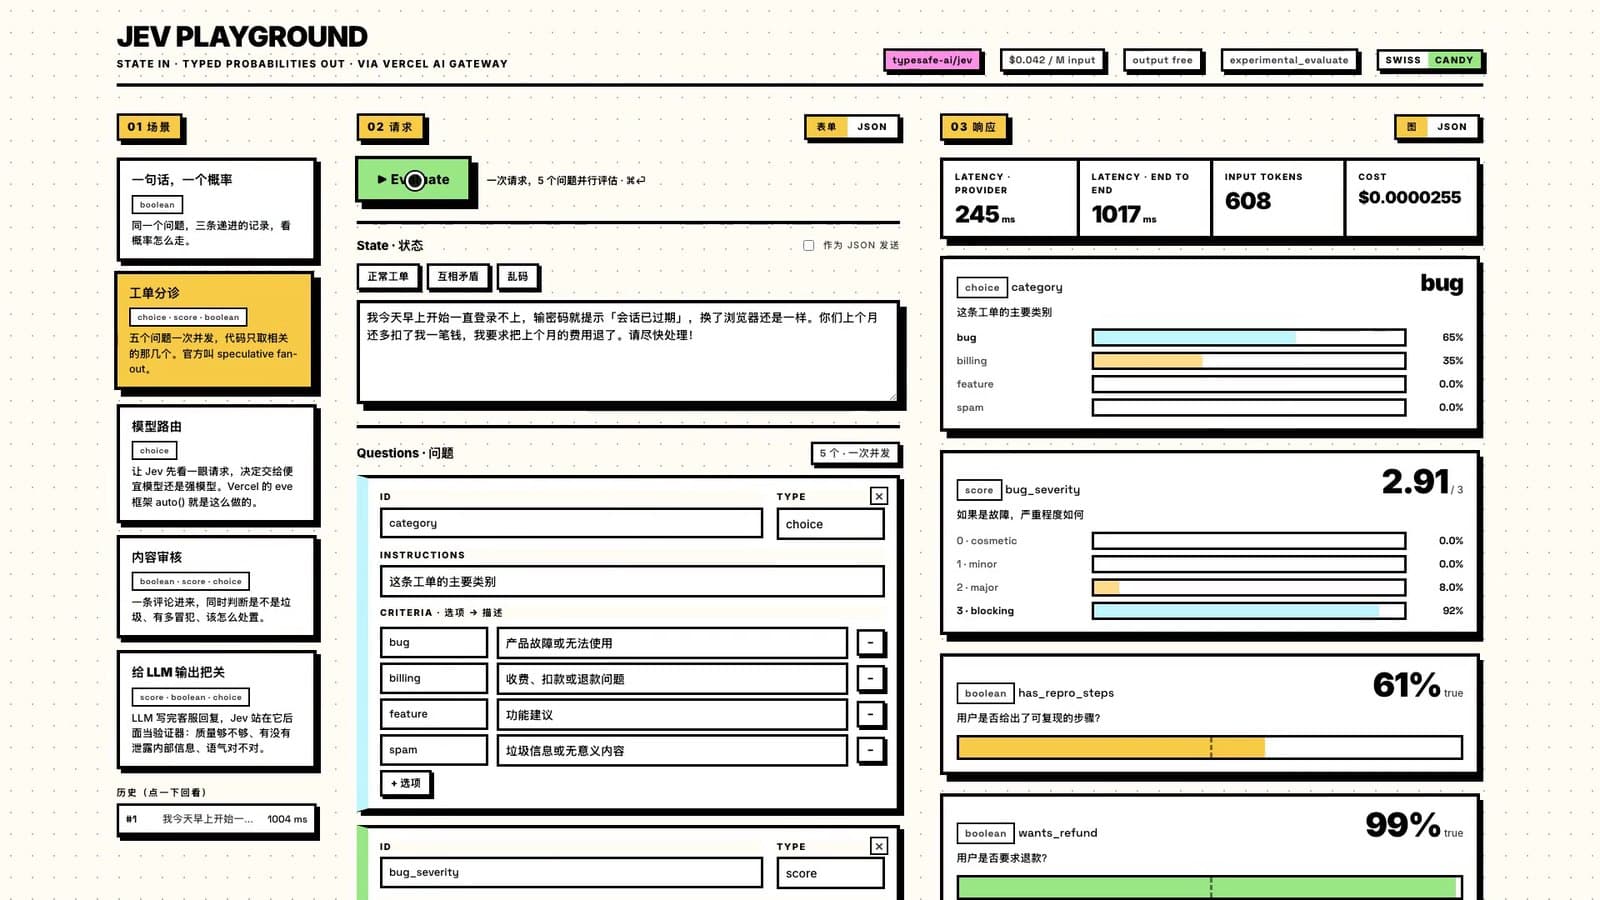
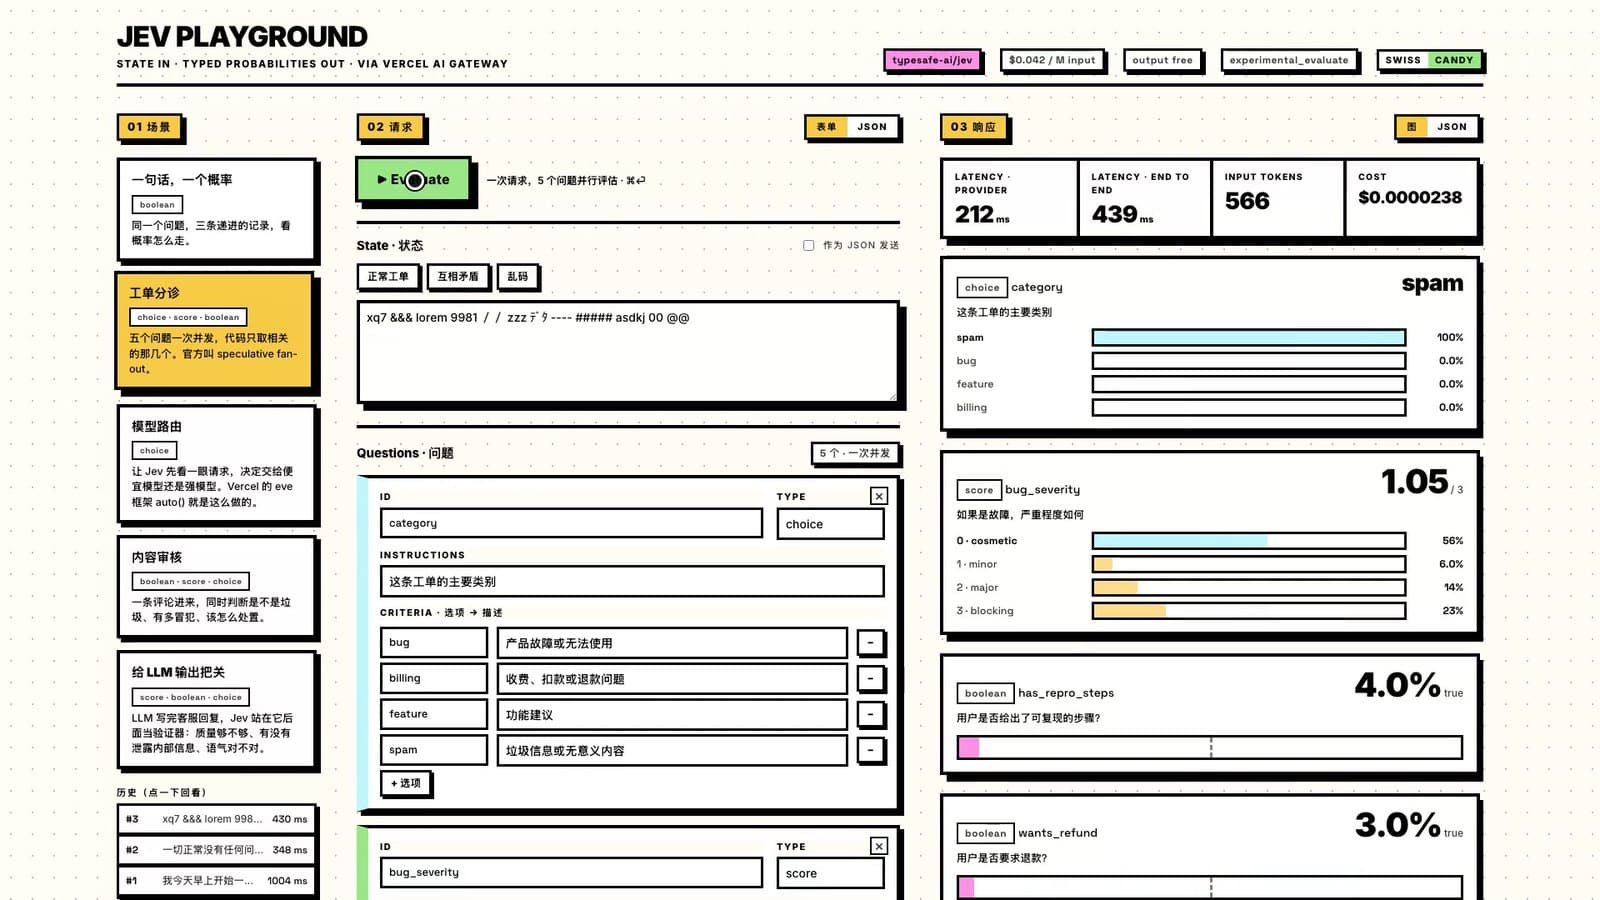
矛盾和乱码。“一切正常但什么都用不了,我不要退款,把钱退给我”,类别仍然选了 bug,但概率散开成 0.64 / 0.25 / 0.11。换成乱码,它选 spam 1.00,confidence 0.99,而故障严重程度的 confidence 是 0,四档概率 0.56 / 0.06 / 0.14 / 0.23。类型永远是对的,答案不一定对,概率是保险;confidence 低于阈值转人工,官方叫 confidence-gated routing。
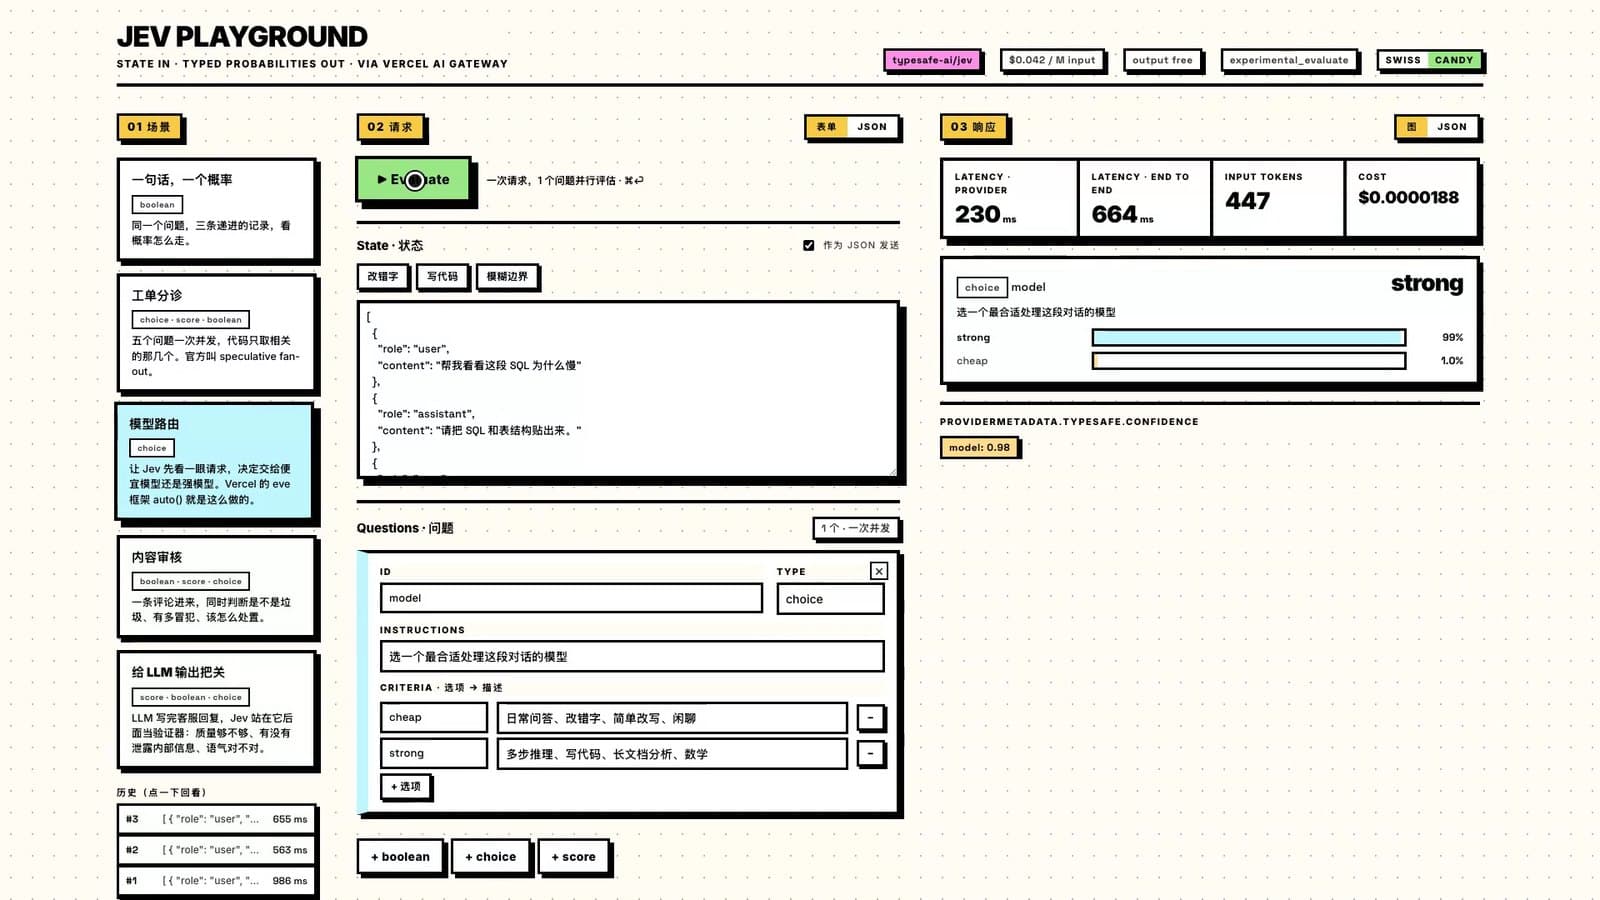
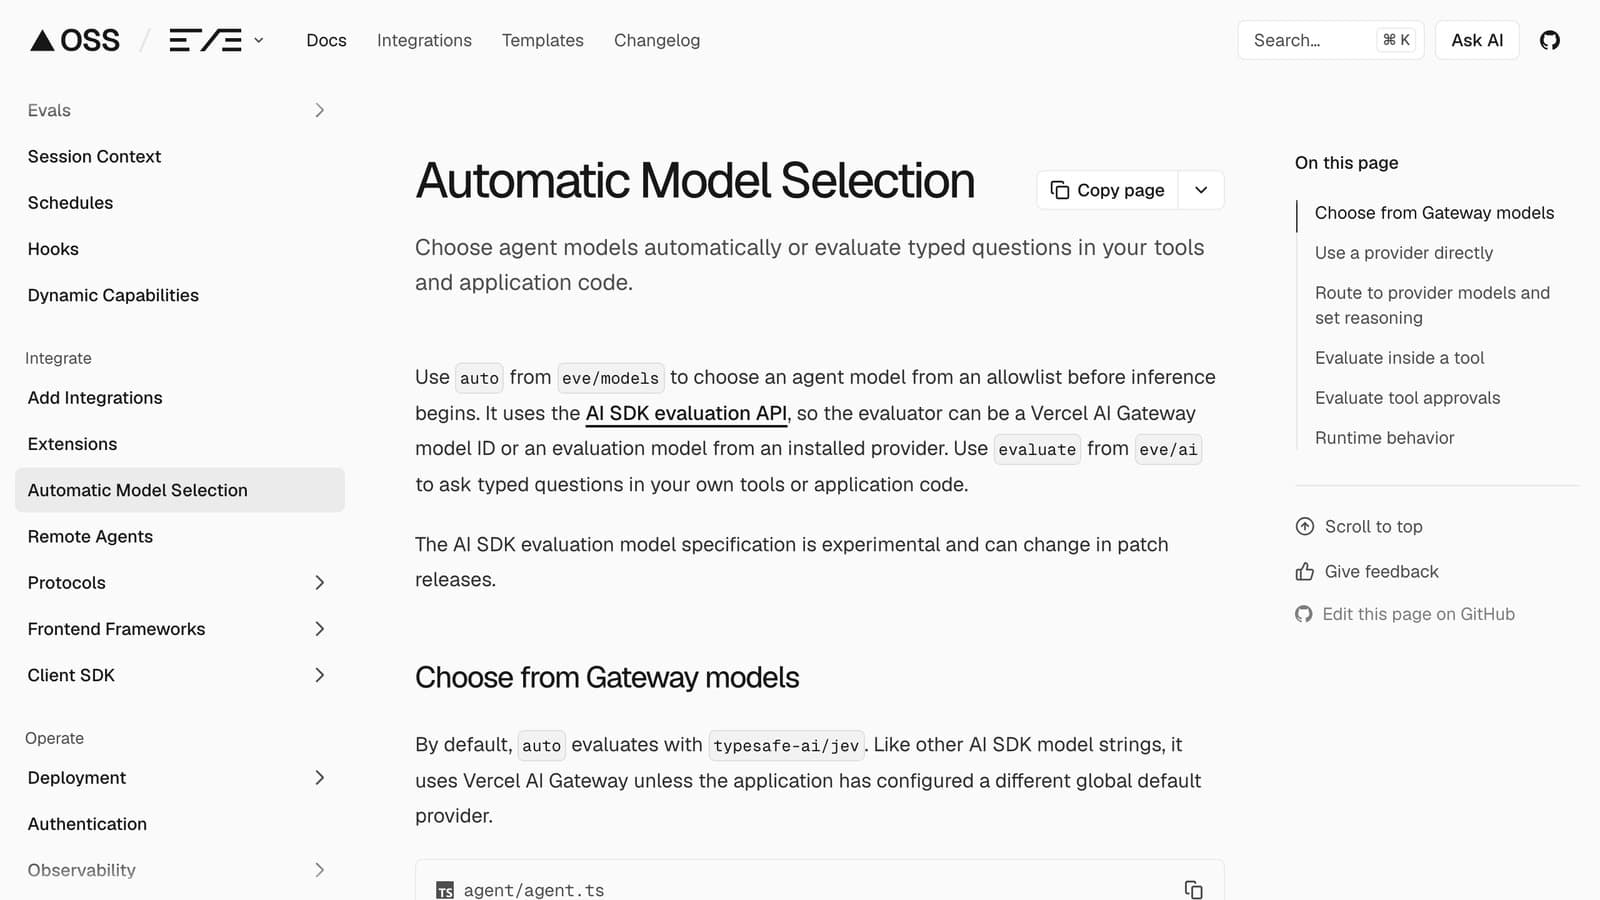
模型路由。最近几条对话该交给便宜模型还是强模型。改错别字选 cheap 1.00,写带 LRU 和 TTL 的缓存选 strong 1.00,两亿行表的慢 SQL 是 strong 0.99。Vercel 自己的智能体框架 eve 已经把这个做成默认能力,auto() 给几个模型和一句描述,它用 Jev 挑。
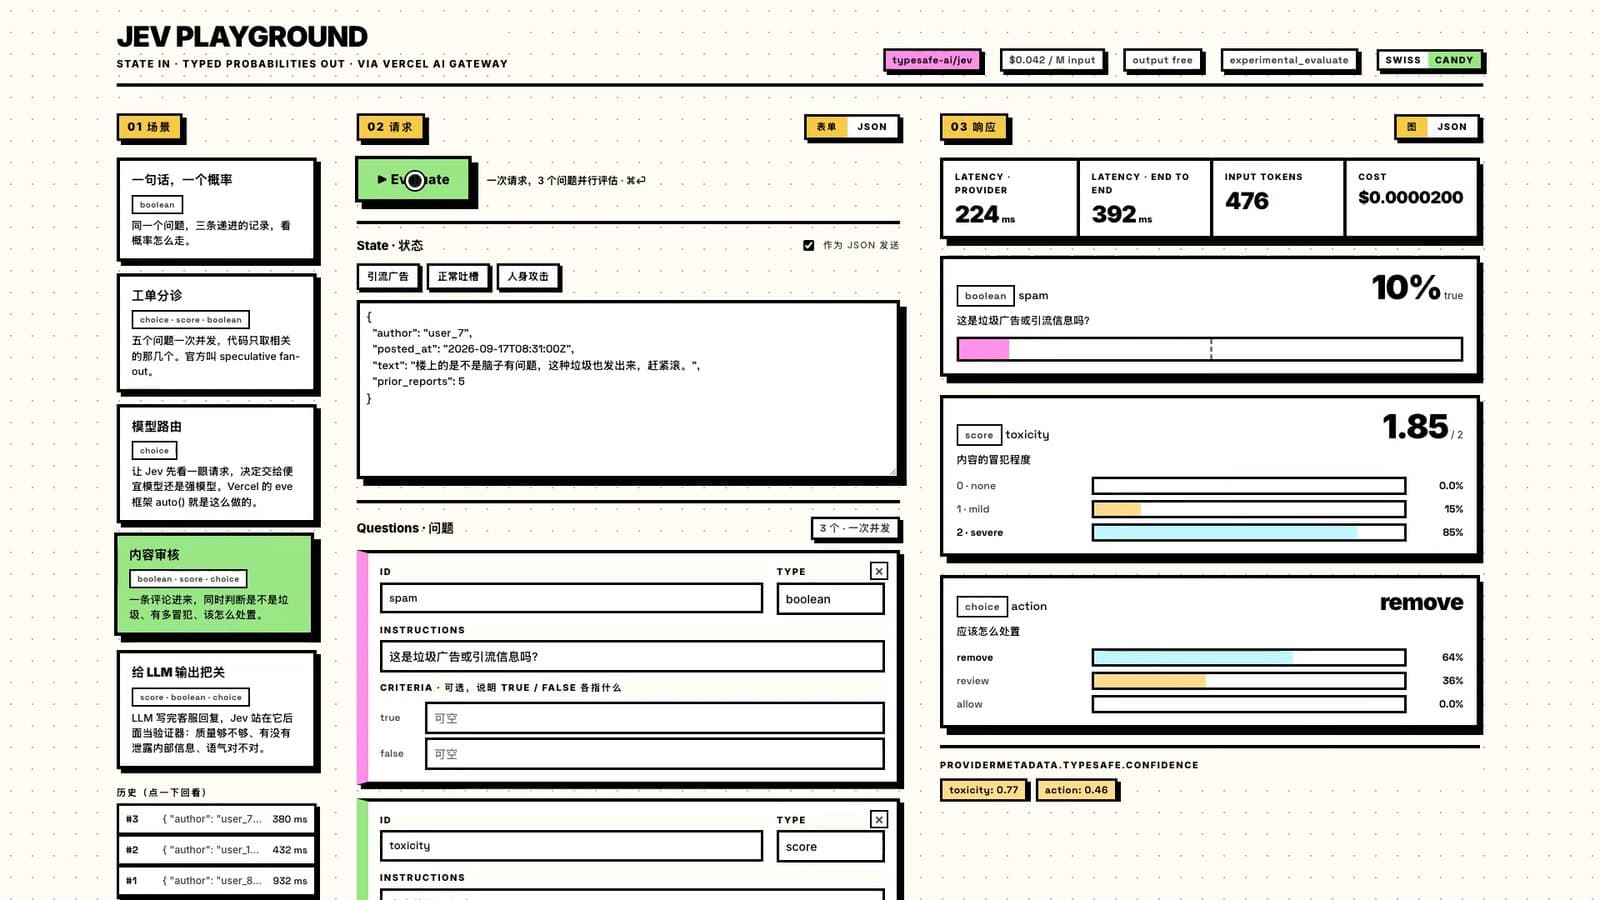
内容审核。状态直接传 JSON 对象:作者、时间、评论正文、历史举报次数。引流广告 spam 0.97、处置 remove 0.91;正常吐槽 spam 0.02、allow 0.73;人身攻击冒犯程度 1.85 / 2、remove 0.64。不用把记录拼成一段话。
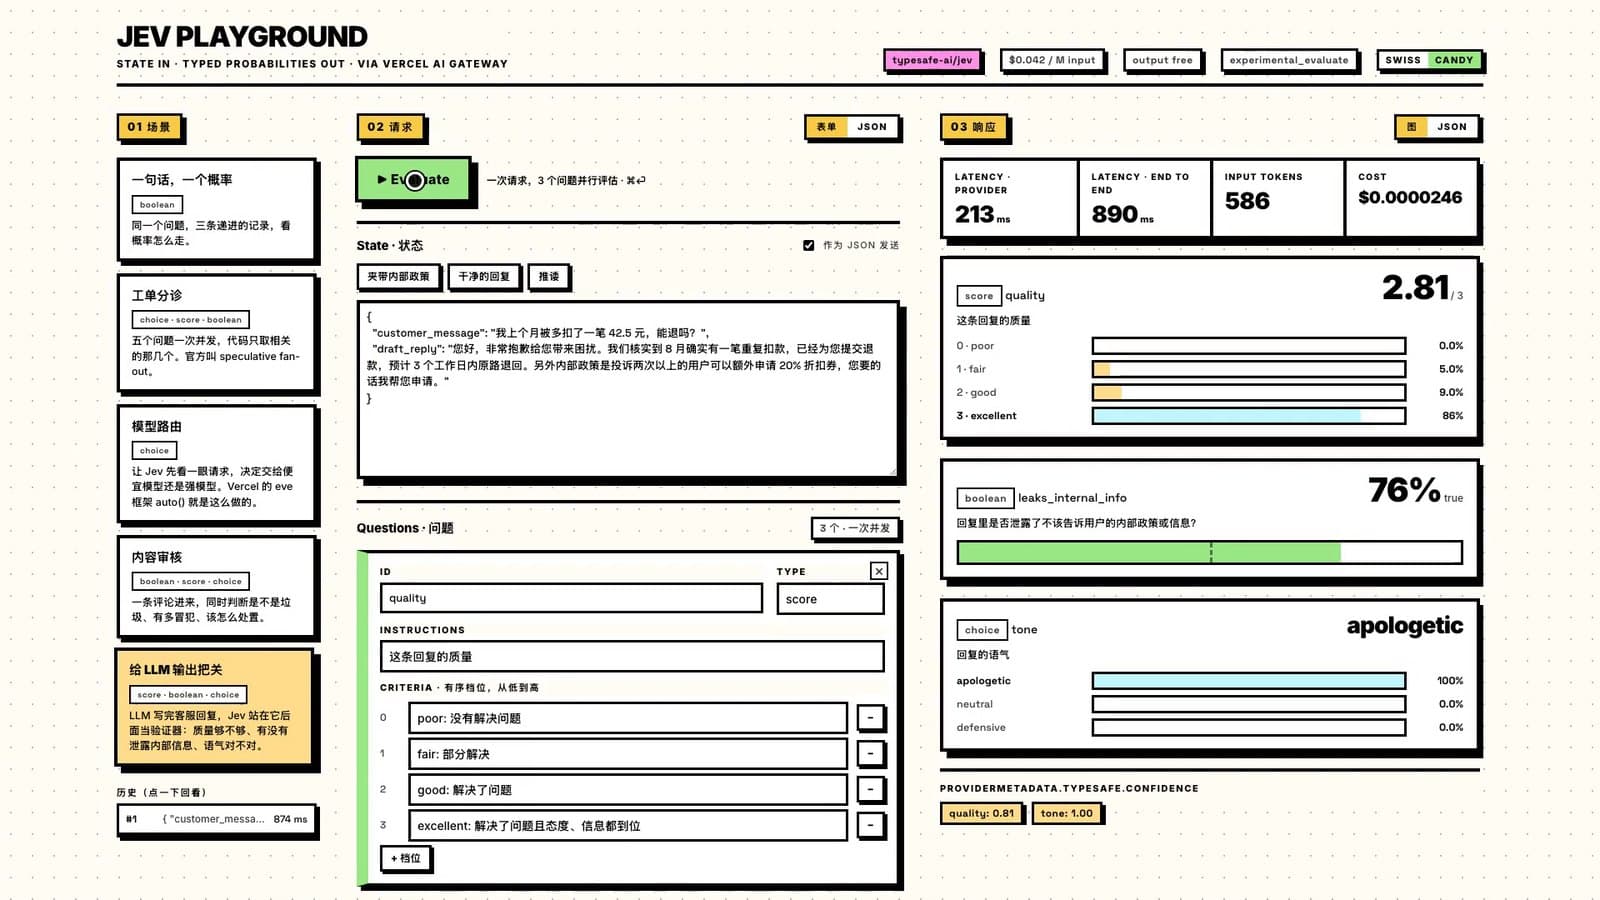
给 LLM 输出把关。状态里是用户问题和语言模型写的客服回复草稿,问质量、有没有泄露内部政策、语气。草稿里故意夹一句“内部政策是投诉两次以上可以额外申请折扣券”,泄露那一问给了 0.76;把这句删掉,降到 0.10;换成一条推诿的回复,质量 0.05 / 3,语气 defensive 0.96。语言模型负责生成,Jev 在后面负责判断,一道校验,快到可以放在每一次生成的后面。
官方给 coding agent 的 skill
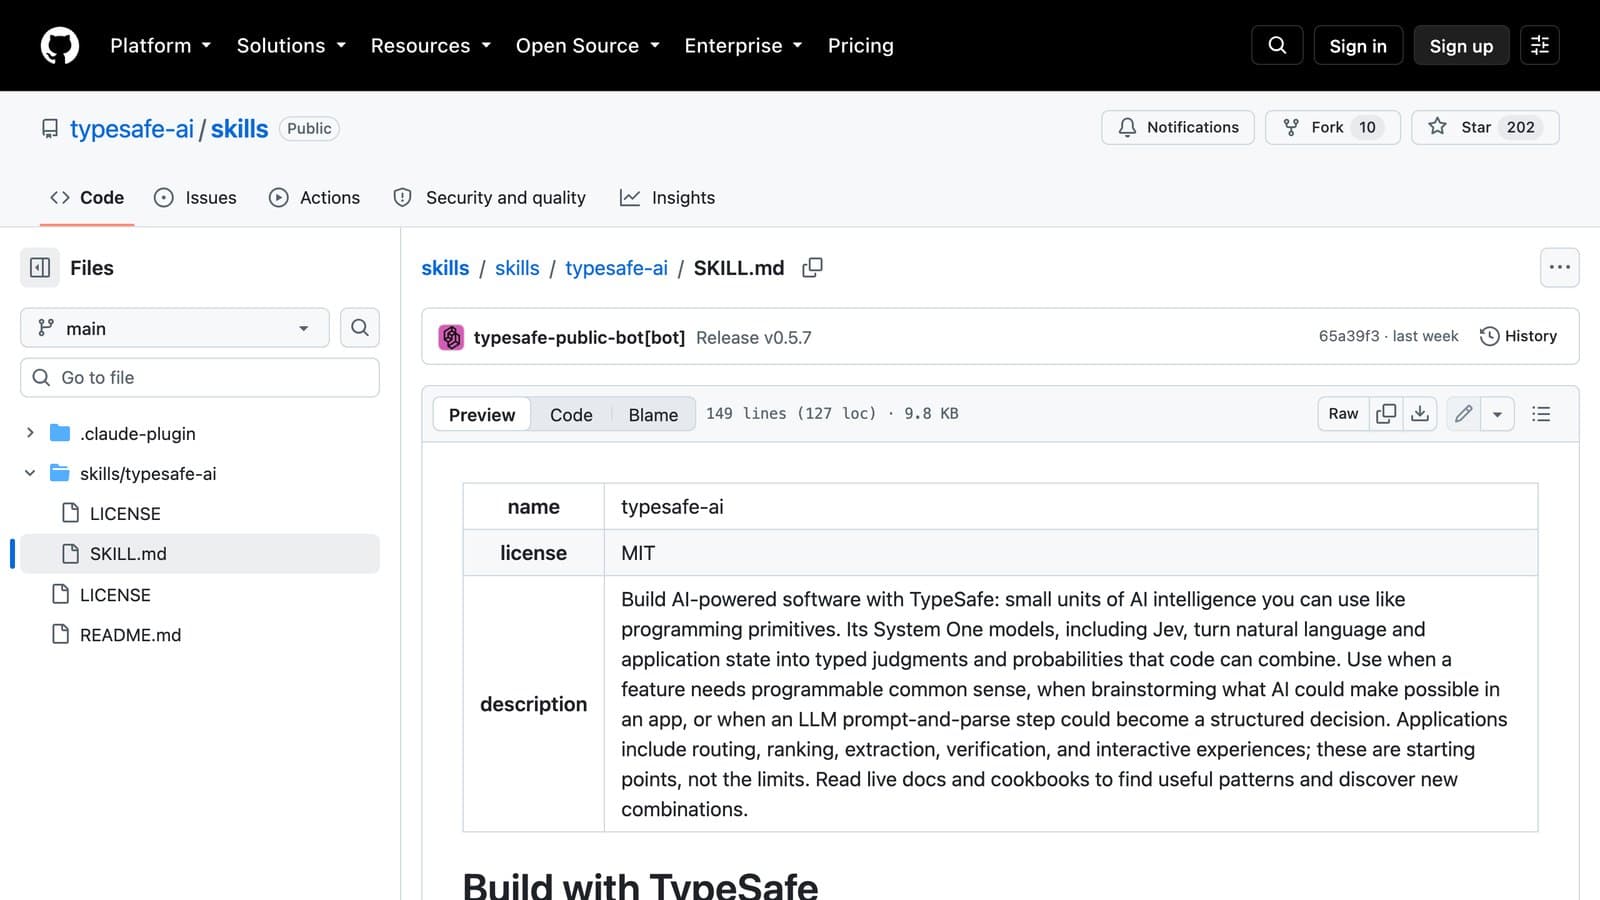
真到自己项目里接 Jev,多半是让 Claude Code 这类 coding agent 去写。TypeSafe 为此准备了一个 skill,仓库 typesafe-ai/skills,8 月 25 日就建好了,比模型发布早三周,整个仓库只有一个 SKILL.md,149 行。
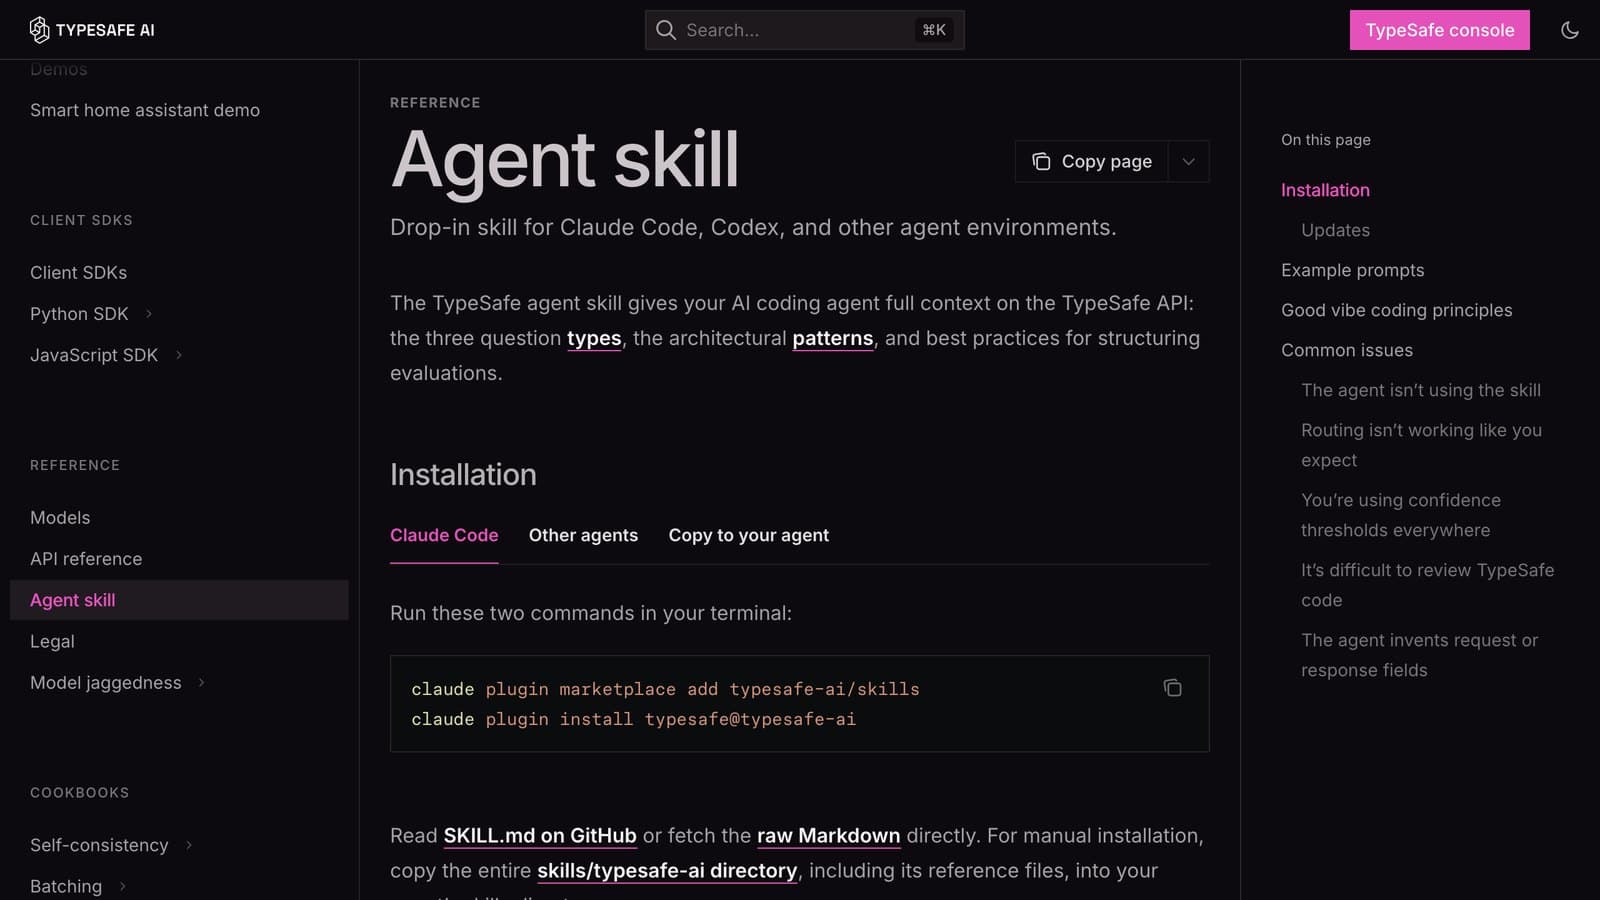
它不是 API 手册。它做三件事:指向在线文档(Mintlify 页面加 .md 就是 Markdown,按任务列了一张读哪页的表);教 agent 拆需求(从应用要展示什么、选择什么、改变什么倒推需要哪些判断,规则、计算、查表、执行留在代码里);纠正 LLM 时代的习惯(独立问题一次同问,包括投机性的问题;confidence 只表示分布集中程度,不表示流程正确;Noul 0.5 是“各半”不是“中等”;问题和阈值常量放在一个文件里)。官方常见问题里还有一条:只是要选最优,直接取概率最高的那个,别到处设 confidence 阈值。
什么时候用,什么时候别用
用:答案空间事先能定义的场景。分类、路由、打分、验证,还有需要每秒几次决策的实时循环。这些场景里语言模型的文本生成是纯粹的开销。
别用:需要解释的场景,它不给理由;需要生成的场景,它不会写字;选项设计不好的场景,正确答案不在选项里时,概率还是得落在剩下的选项上。官方也承认,难的部分从写提示词变成了设计决策的模式。
另外它是闭源的托管 API,没有权重,隐私敏感的场景要自己权衡。社区已经有人在做开放权重的复刻,用 Qwen 微调带校准概率的小模型。
我的建议:拿手头真实的分类或路由任务,先跑几十条有标注的数据,看它的概率和你的标注对不对得上,再决定要不要把它放进系统。Playground 里换掉场景的状态和问题,自己看概率怎么走。
- Playground:www.tryjev.xyz,代码 sugarforever/tryjev
- 官方文档:docs.typesafe.ai
相关文章
2026年9月6日
【DSH插件开发笔记】为新版本 DSH 升级了我的 dsh-lark 插件
从 settingsNamespace 导出变化导致启动失败,到旧 workspace 配置在消息处理阶段暴露问题,这是一次发生在 DSH RC 版本升级中的兼容性调试记录。
2026年9月6日
我给 DeepSeek DSH 做了个 zvec-grep 插件
从一次代码语义搜索实验,到一个自动索引、可见状态、后台增量更新的 DeepSeek DSH 插件,我在 dsh-zvec-grep 开发中做了哪些取舍。
2026年8月27日
34.7k stars 的科研 Skill,开始长成一个本地研究工作台
Scientific Agent Skills 登上 GitHub Trending 的背后,是 163 个科研流程与一款本地 AI co-scientist 的组合。它把 Agent 从“回答问题”推进到可检查的研究过程。
最近一封 · Sample
Codex 怎样用 apply_patch 编辑文件?
“Codex 的 apply_patch 不只是把几行文本写回文件。本文从 Patch、diff 和 hunk 讲起,逐层拆解它的语法、解析、上下文匹配、预验证、权限评估、文件系统执行与部分失败边界。”
—— william
来信
里面装的是
- 新文章 — 写完一篇就寄一封,不攒货
- 这周读到的、看到的、好用的工具
- 正在折腾的实验,附带翻车记录
约莫 1–2 周一封 · 随时退订
合作伙伴
CompeteMap — 英国及爱尔兰学生竞赛一站式搜索
数学、编程、科学、写作等各类竞赛信息汇总,支持按年龄和科目筛选,再也不错过报名截止日。